
日本語特化で高速かつ高精度な文字起こしAI「Haas-ja-v1.0」が登場、オープンモデルの中で最高性能を記録
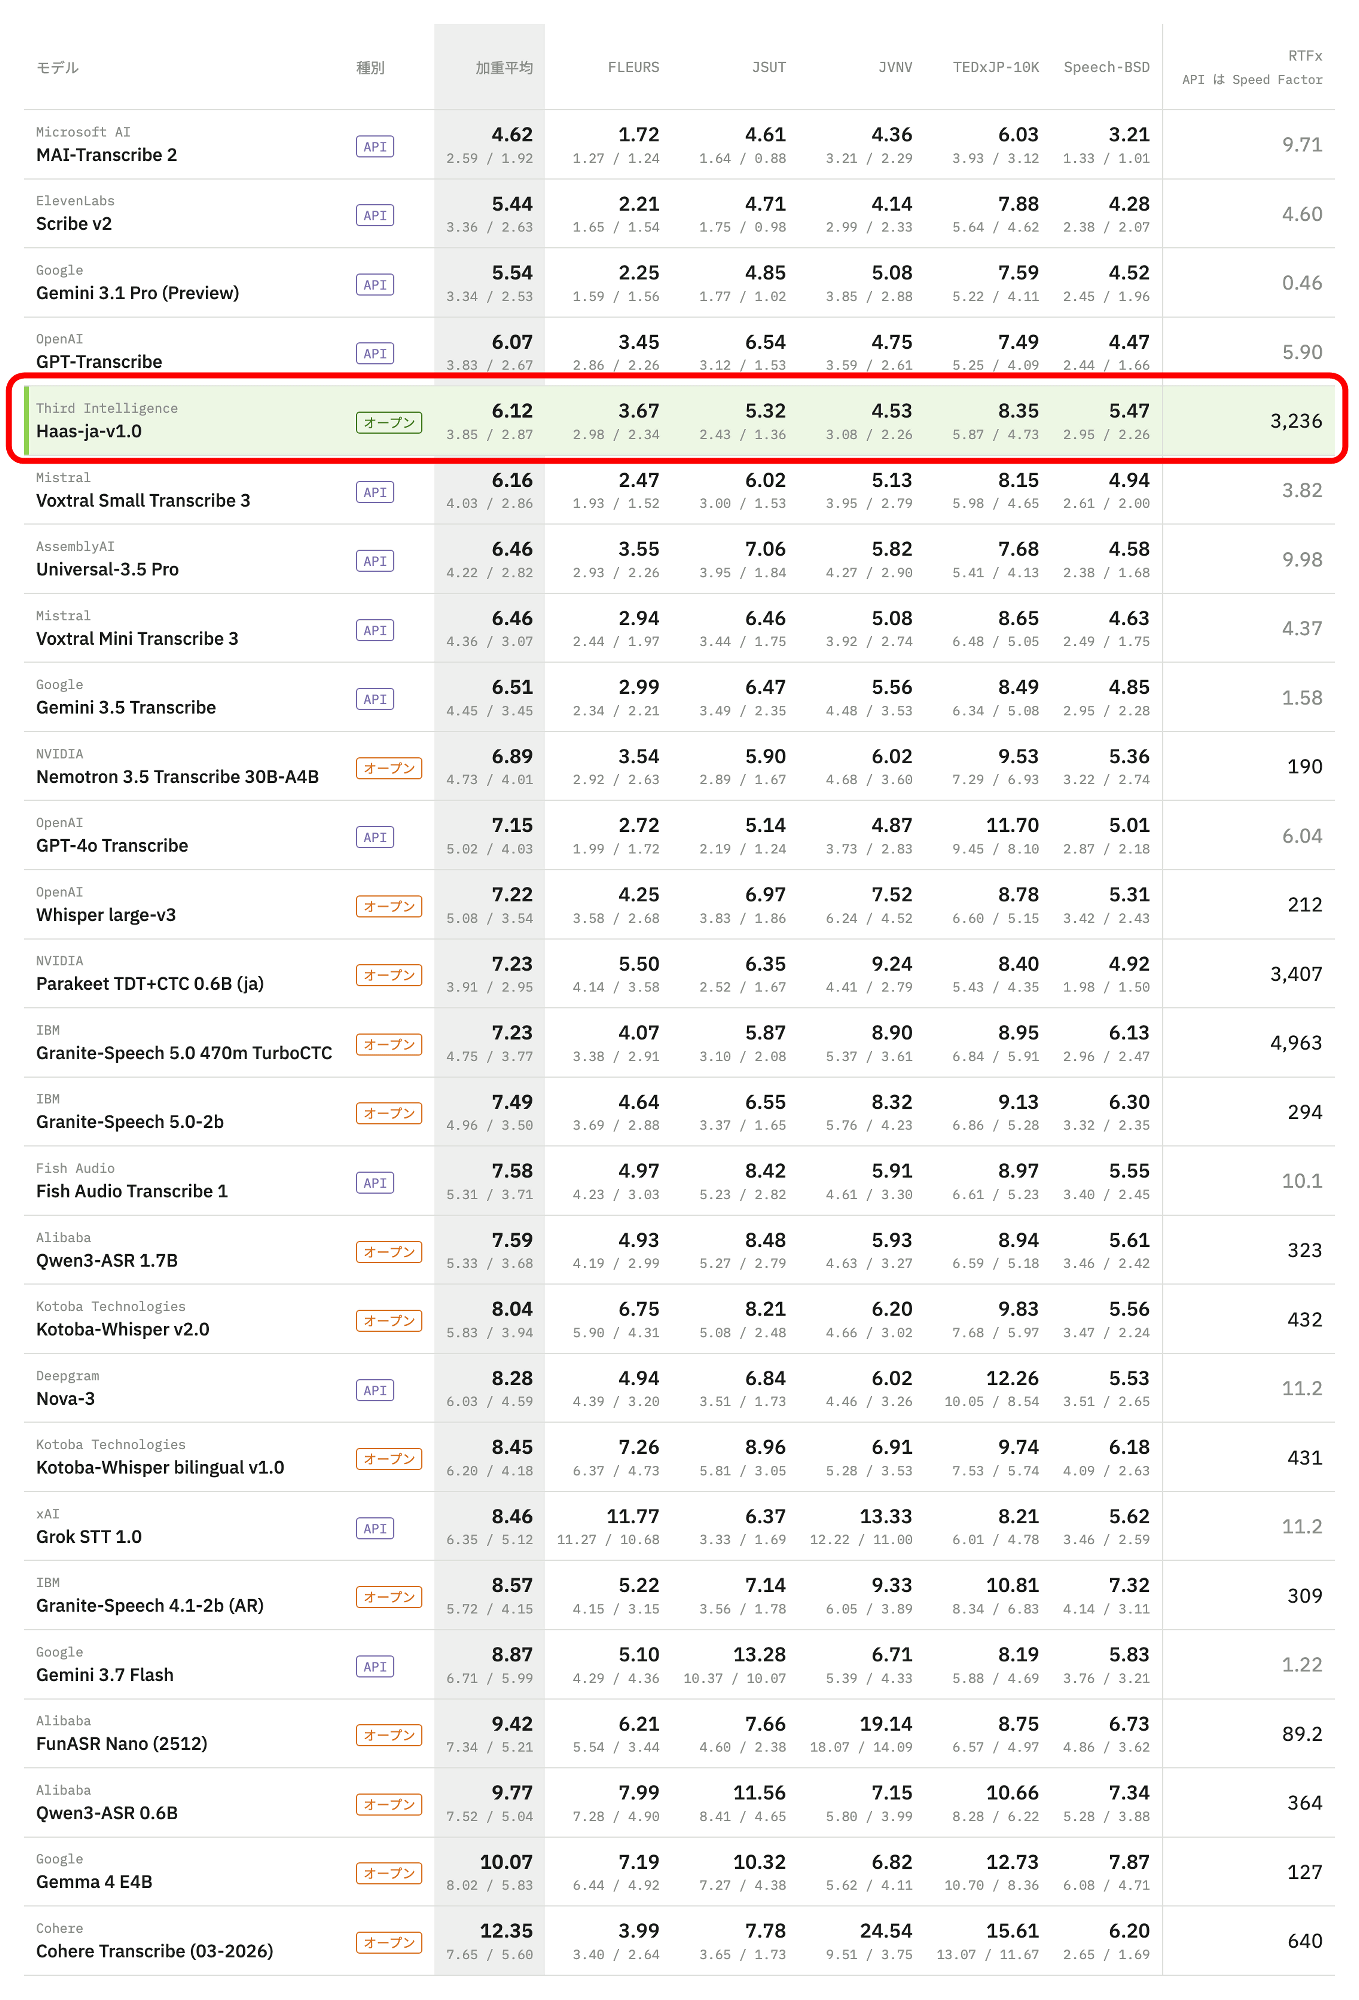
日本のAI企業であるThird Intelligenceが日本語特化の音声認識モデル「Haas-ja-v1.0」を公開しました。パラメーター数6億1580万の軽量モデルで、精度の高さと処理の速さを両立していることがアピールされています。
日本語音声認識モデル Haas-ja-v1.0 の公開
https://third-intelligence.com/ja/posts/haas-ja-v1-release
新たな日本語の音声認識モデル Haas-ja-v1.0 を開発し、OSSとして公開しました!高い精度と推論効率を両立し、評価したオープンウェイトモデルの中ではトップの精度を達成しています。デモ等も公開していますので是非ご利用下さい! pic.twitter.com/m3ETDUhYyH
— Tatsu Matsushima (@tatsunari_m) October 30, 2026
各種文字起こしAIの日本語文字起こし精度を測定した結果が以下。Haas-ja-v1.0はオープンモデルの中で最も高スコアで、商用モデルのGemini 3.5 transcribeより高いスコアを記録しています。
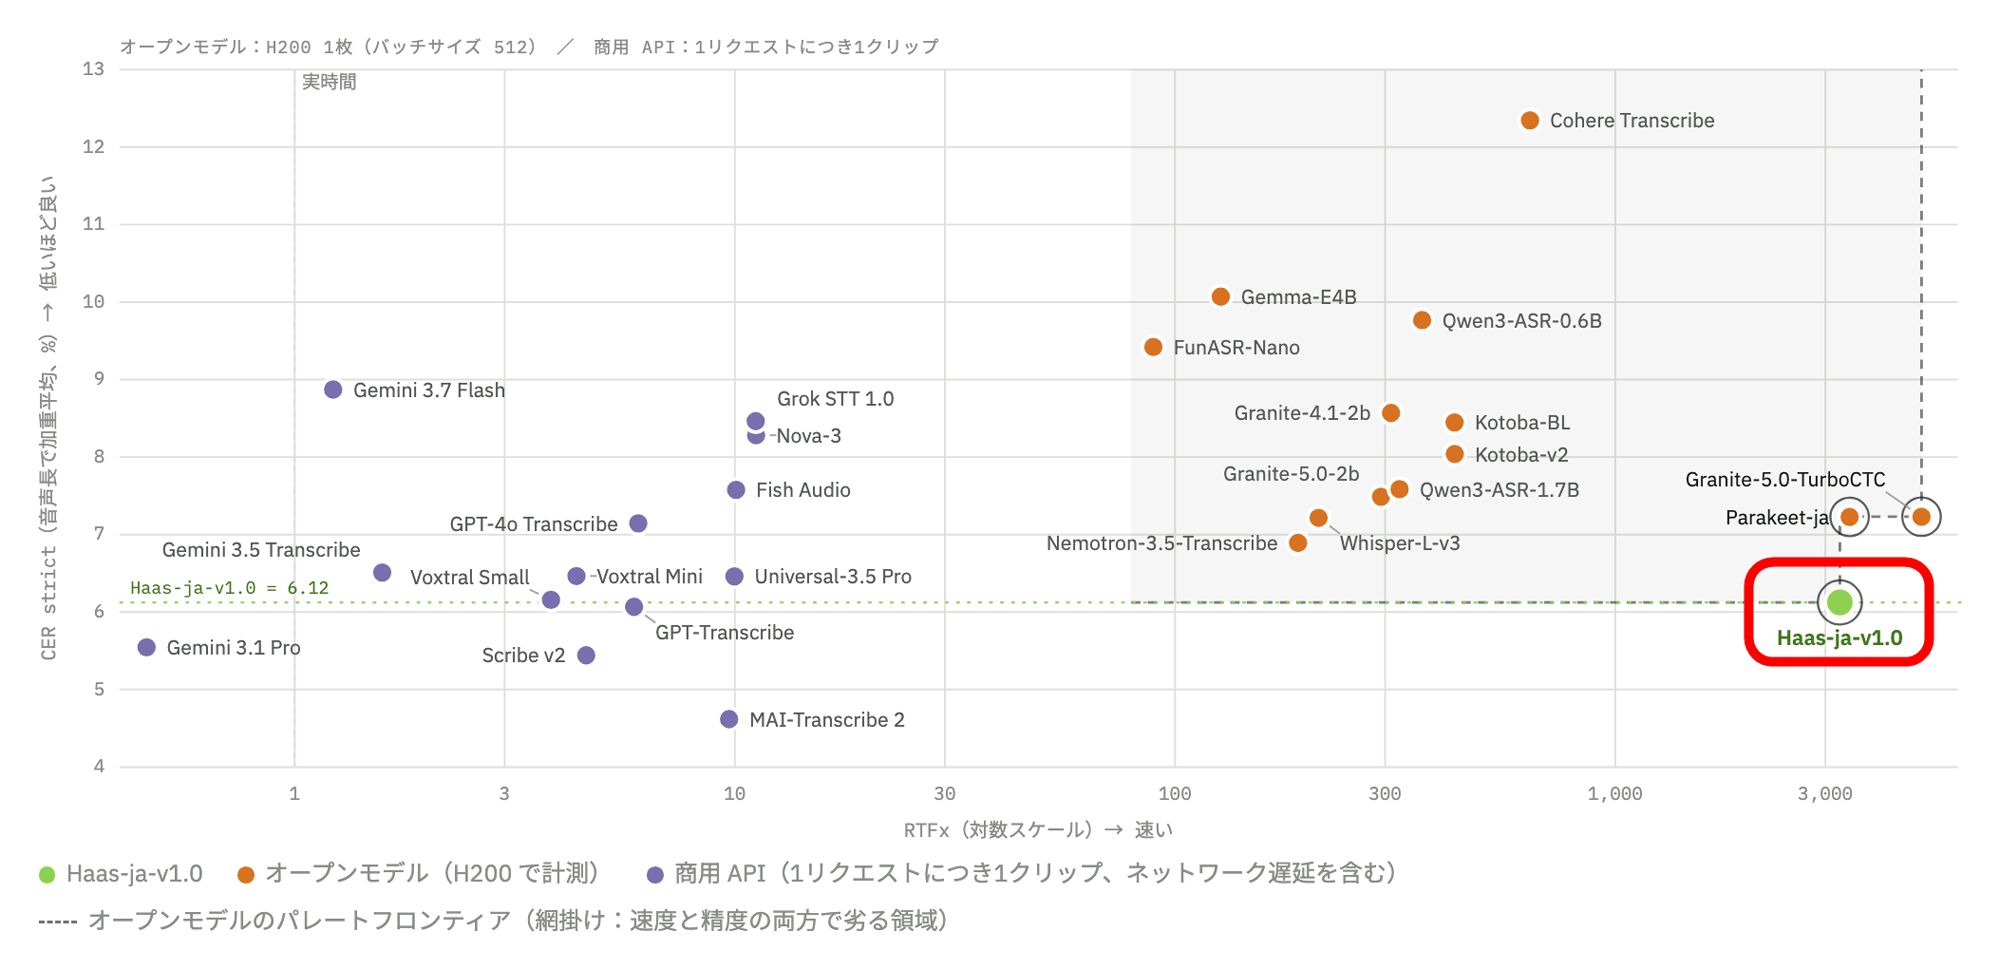
Haas-ja-v1.0は処理の速さも特徴です。以下のグラフは横軸が推論速度、縦軸がエラー率を示しており、Haas-ja-v1.0が高速かつ高精度であることが分かります。
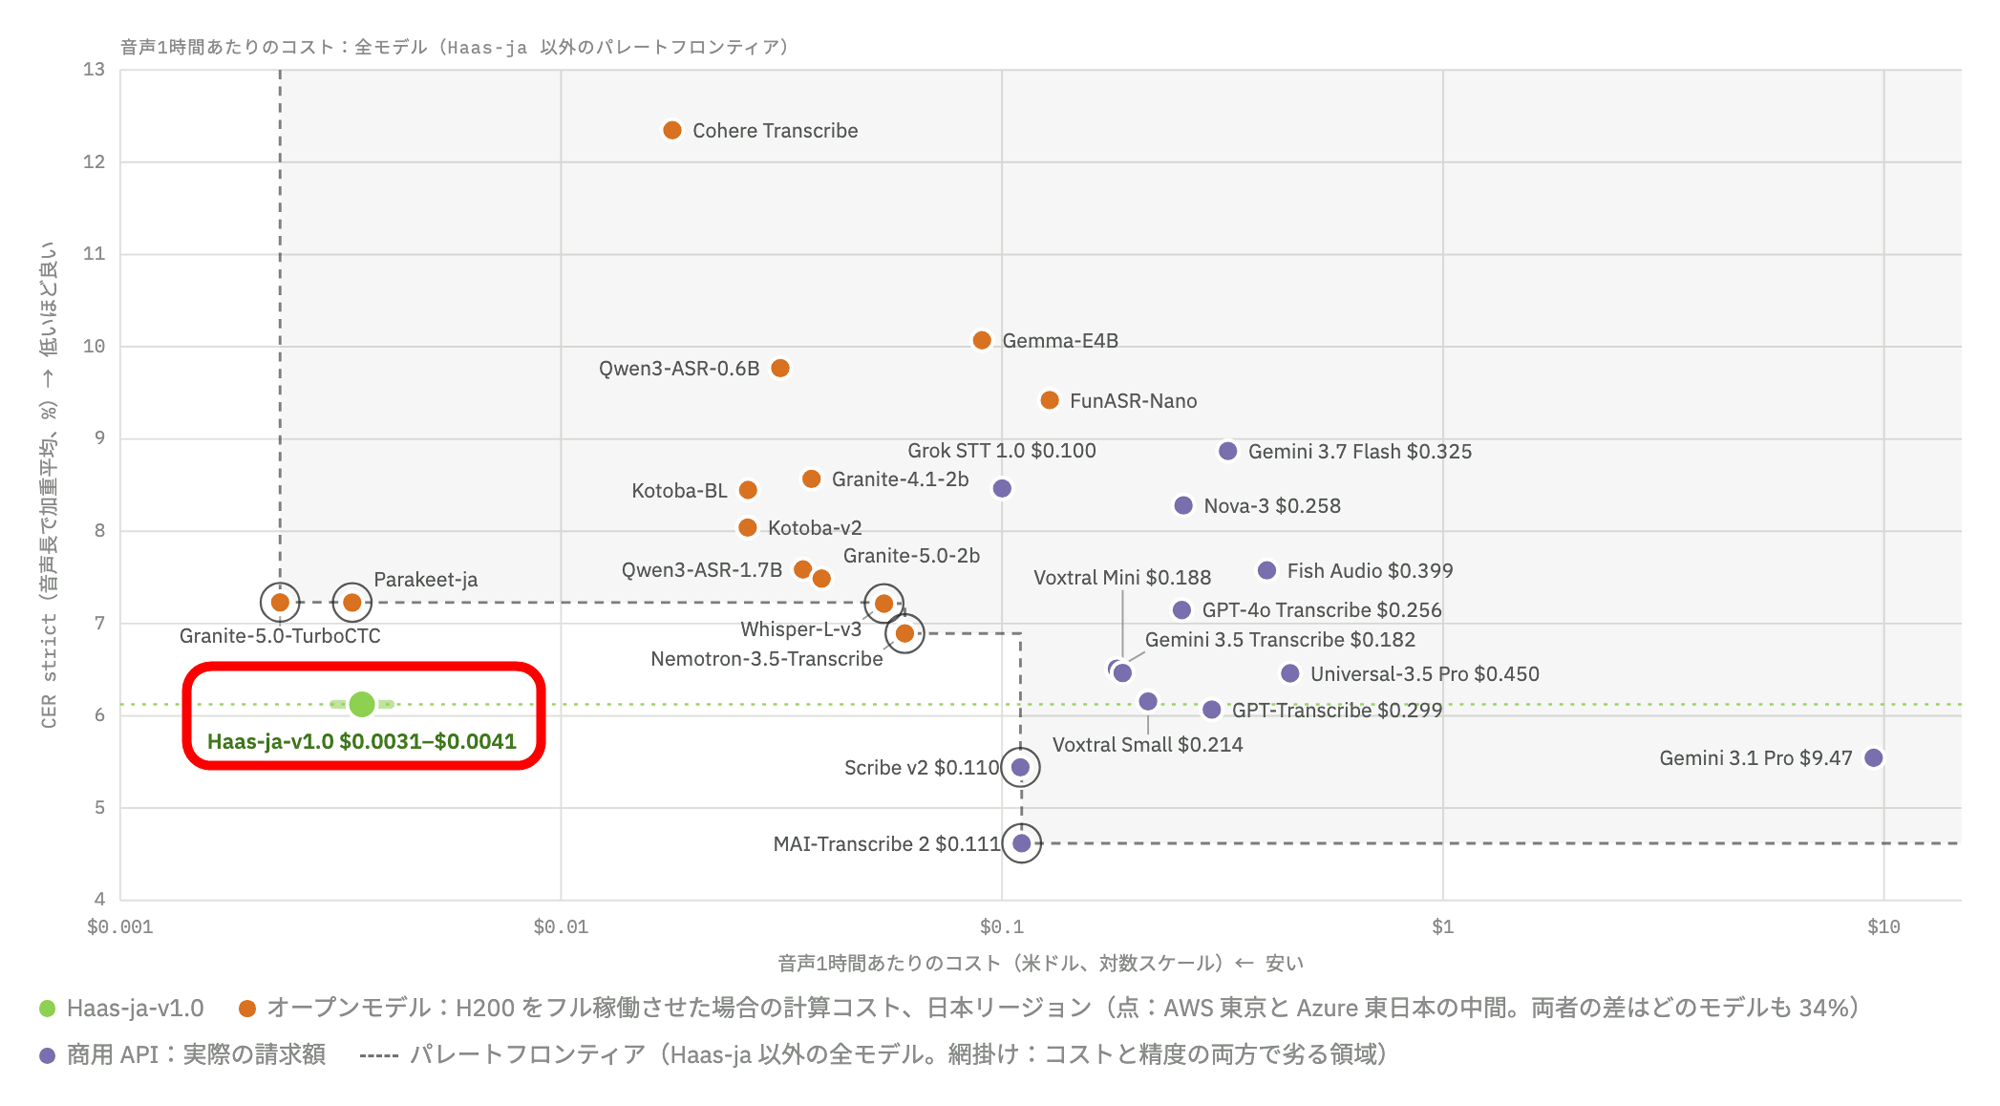
横軸にコストをとったグラフが以下。商用モデルはAPI料金、オープンモデルは「日本リージョンでH200を使用して推論した場合の料金」を参照しています。グラフからは、Haas-ja-v1.0が同等精度のモデルの中で最も低コストであることが示されています。
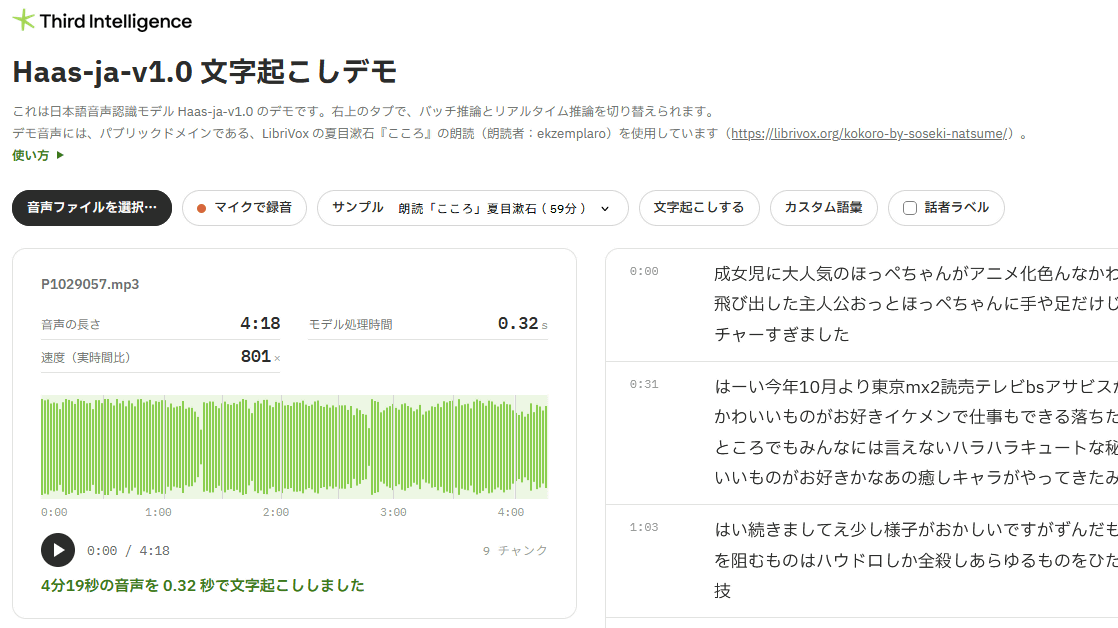
無料のデモが以下のリンク先で公開されているので使ってみました。
Haas-ja-v1.0 文字起こしデモ
https://third-intelligence-haas-ja-v1-0.hf.space/longform
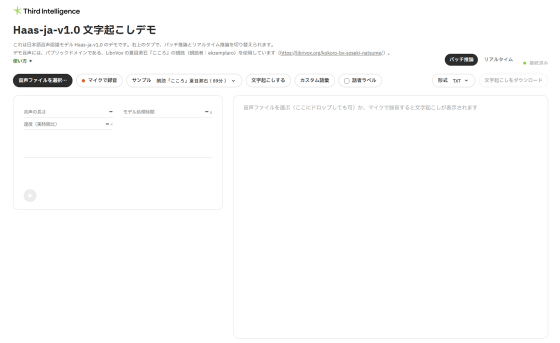
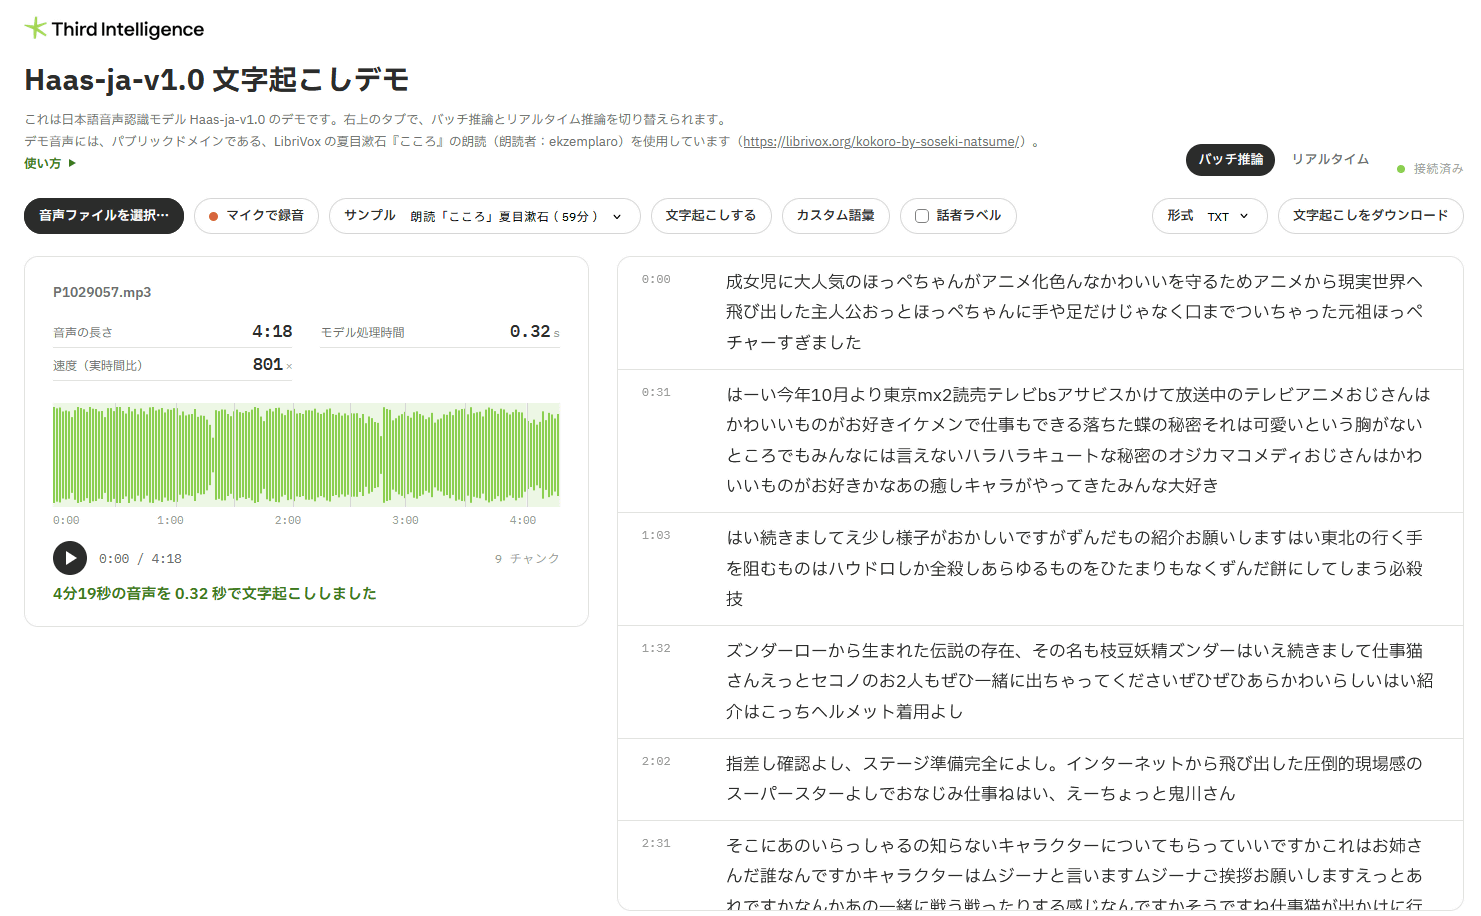
ステージイベントの動画から抜き出した4分19秒の音声を入力した結果、アップロード完了からわずか0.32秒で文字起こしが完了しました。
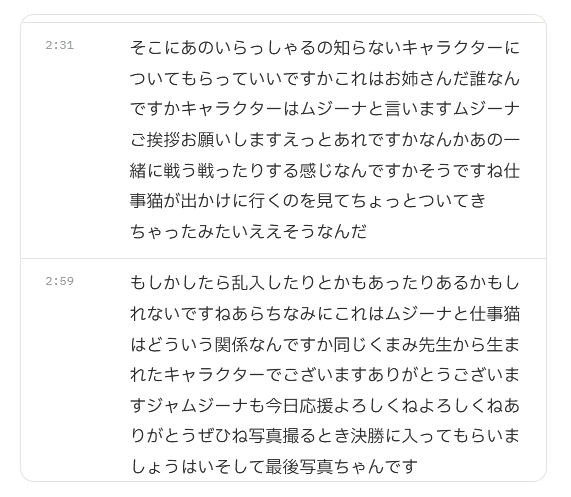
文字起こし結果の一部が以下。「くまみね先生」が「くまみ先生」になったり、「邪神ちゃん」が「写真ちゃん」になったりしているため人力で手直しが必要ですが、爆速な割りに高精度であることが分かります。
Haas-ja-v1.0はオープンモデルとしてHugging Faceで公開されており、推論コードもGitHubで公開されています。ライセンスはApache License 2.0です。
third-intelligence/Haas-ja-v1.0 · Hugging Face
https://huggingface.co/third-intelligence/Haas-ja-v1.0
GitHub - third-intelligence/Haas-ASR: Inference code for Haas, fast and accurate Japanese speech recognition · GitHub
https://github.com/third-intelligence/Haas-ASR
・関連記事
声を指定して好きなセリフを喋らせられるローカルAI「Irodori-TTS」のV3が出たので使ってみた、音声の長さを指定可能で絵文字感情制御も簡単に - GIGAZINE
無料で完全にWindowsでローカル動作できるElevenLabs代替ツール「VoiceStudio」、音声クローン・音声デザイン・動画吹き替え・音声入力・文字起こし・オーディオブック作成を多言語で可能 - GIGAZINE
NVIDIAが文字起こしAI「Nemotron 3.5 Transcribe」を公開、大勢が同時に話す場面でも高精度な話者識別が可能 - GIGAZINE
人間と区別できないほど自然に会話できる音声AI「Prism」が登場、発言内容を事前確認できる仕組みを搭載 - GIGAZINE
人間が話し終わる前に検索や処理を開始する音声AI「Phonic-1」が登場、応答までの待ち時間を大幅に短縮 - GIGAZINE
・関連コンテンツ
in AI, Posted by log1o_hf
You can read the machine translated English article Haas-ja-v1.0, a high-speed and highly ac….