
動画系AIのRunwayが動画から世界を理解してロボットを動かすためのAI「Praxis-1」を公開
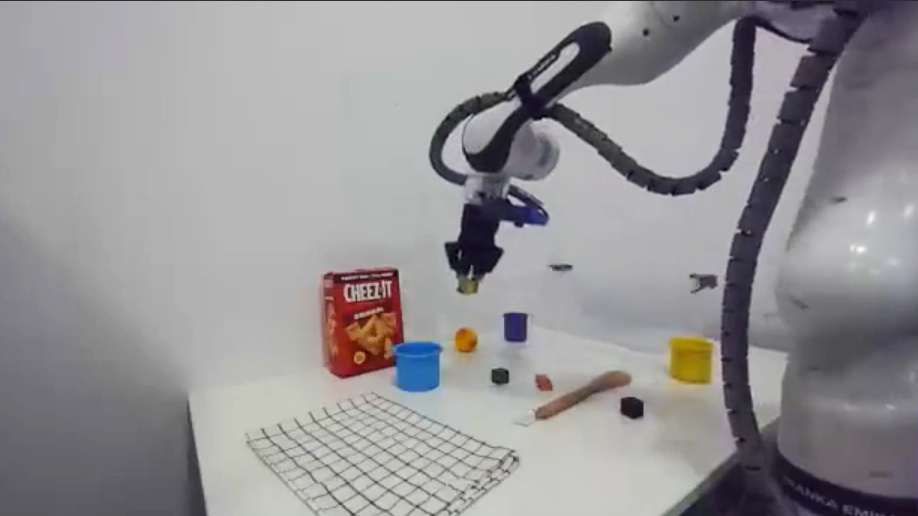
動画生成AIの「Runway」シリーズや動画編集AI「Aleph 2.0」などを展開するアメリカの生成AI企業・Runwayが、動画の事前学習を実際のロボットの制御に変換するオープンウェイトワールドアクションモデル「Praxis-1」を発表しました。
Praxis-1: From Video Pretraining to Robot Control | Runway Research
https://runway.com/research/praxis-1-video-pretraining-to-robot-control
Today, we’re making Praxis-1 available to everyone. Our state-of-the-art world action model turns video pretraining into control for real robots, and it ships with open weights under Apache 2.0, ready to run and fine-tune on your own hardware. pic.twitter.com/jL5ZmpY6x9
— Runway (@runwayml) 2026年11月11日
Runway Praxis-1 Is Now Available: Open-Weight Robotics Model
https://runway.com/news/company-news/praxis-1-is-now-available
ロボット制御AIの開発には「ロボットの動きに関するデータ」が大量に必要ですが、データの収集には大きなコストがかかります。そこでRunwayは「最も拡張性の高いデータソースは、人々が日常的に撮影している一般的な動画である」と考え、動画から物体の挙動や手の動き、作業の様子などを予測するようAIモデルを学習しました。
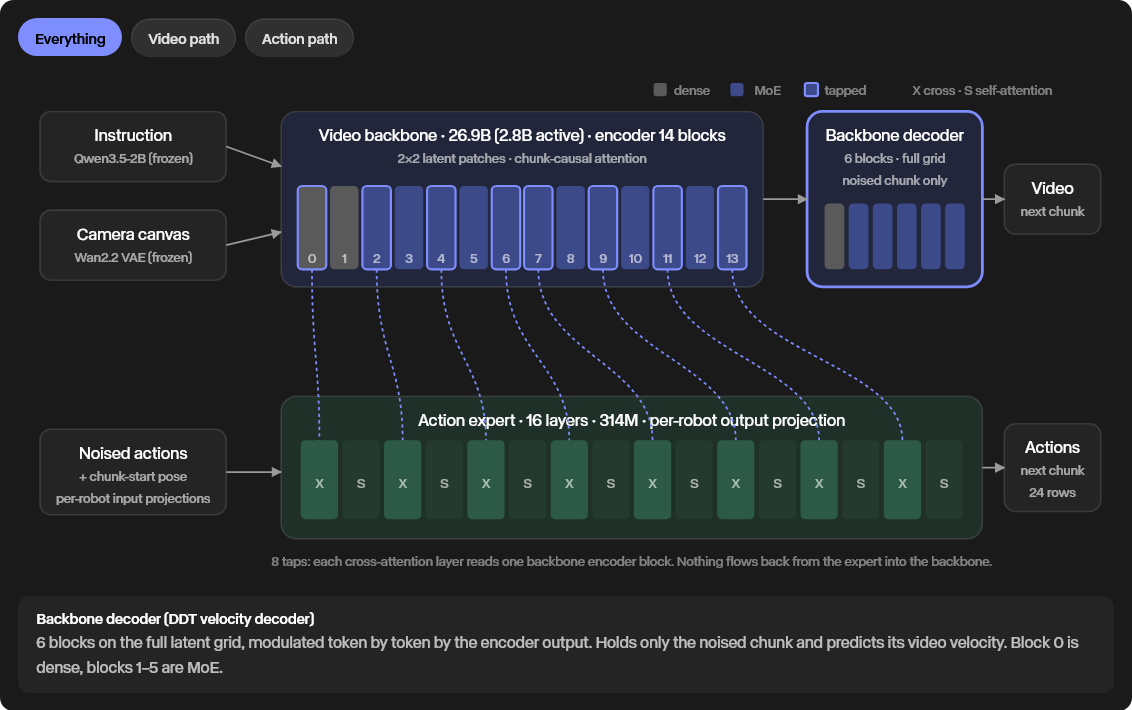
こうして誕生したのがPraxis-1です。Praxis-1は、270億個のパラメータを持つRunwayの動画基盤モデルをベースとしており、ローカルで実行することが可能。NVIDIA GeForce 5090で実行可能なNVFP4量子化モデルも用意されています。
.@Runwayml’s Praxis-1 is a 27B-parameter open-weight world action model that is optimized to run locally on NVIDIA RTX 5090.
— NVIDIA RTX Spark (@NVIDIARTXSpark) 2026年11月11日
Praxis-1 is a leading world action model on NVIDIA’s RoboLab-120 leaderboard.
Download the NVFP4 checkpoint on Hugging Face: https://t.co/ZPN2Kw7ww7 https://t.co/DJ2gs84w0f
Praxis-1は、未来を短い単位で予測する「オープンウェイト世界モデル」に変換し、小型のアクションエキスパートが動画基盤モデルの内部状態を読み取り、次に何が起こるかを想像します。ロボットが行動するたびに、Praxis-1はシーンがどのように見えるか、そしてそこに到達するまでの動きの両方を予測します。具体的な行動を学習する前に「動画から世界の仕組みを学習する」という手順を挟むことで、広く適応可能なロボット用モデルとして機能するというわけです。
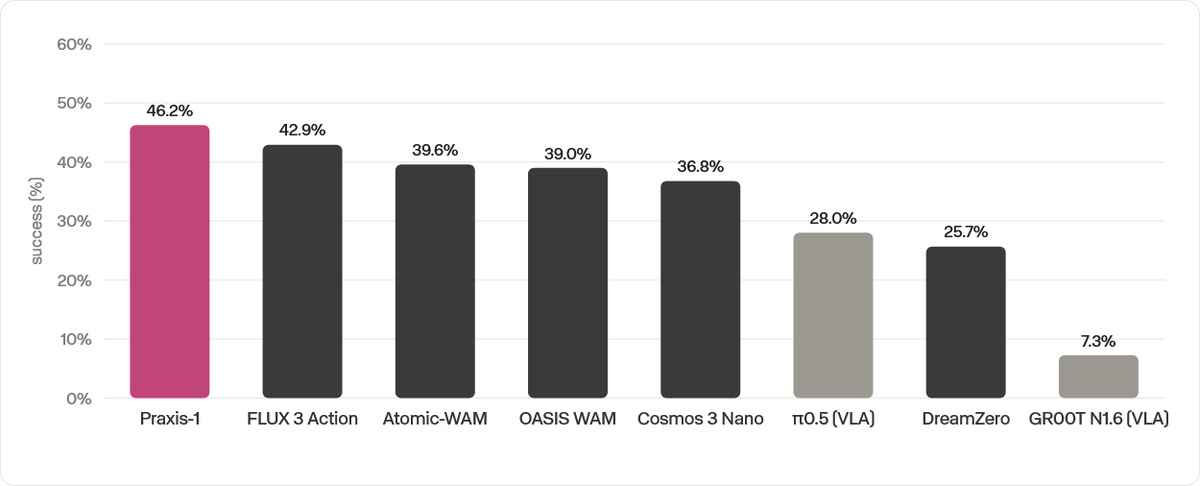
Praxis-1を評価するため、ロボットの動作制御のベンチマークとして用いられる「Robolab-120」と、ロボティクスとAIに特化したロボットシステムである「FRANKA RESEARCH 3」のロボットアームが用いられました。結果としてPraxis-1は、1200のシナリオ中555(46.2%)を解決し、「世界行動モデル」およびリーダーボード上の「オープンソースロボット基盤モデル」の中でいずれも最高の成績を収めたと報告されています。これまで最高のスコアを記録していたロボット制御向け世界行動モデル「FLUX 3 Action」が公開した10個の単一項目シナリオについてFRANKA RESEARCH 3を用いたタスクでも、FLUX 3 Actionの「80」を上回る「88」をPraxis-1は記録しました。
また、最先端のマルチモーダルモデルは、ツールやコードインターフェースを介して、ロボットアームをゼロショットで駆動できるようになっています。OpenAIが2026年9月に発表した「GPT-6 Astra」は、ロボットの物体操作ベンチマーク「RoboDojo」で成功率22.5%を記録し全ての公開エントリーを上回っており、Robolab-120のリーダーボードをリードする存在になっています。しかしマルチモーダルモデルは世界行動モデルと比較すると欠点としてレイテンシとコストの問題があり、実際にRunwayが同じ3つのタスクでPraxis-1とGPT-6 Astraを実行したところ、平均するとGPT-6 Astraはタスクの完了に15.6倍の時間がかかり、完了したタスク1つあたりのコストは51倍高くなったそうです。
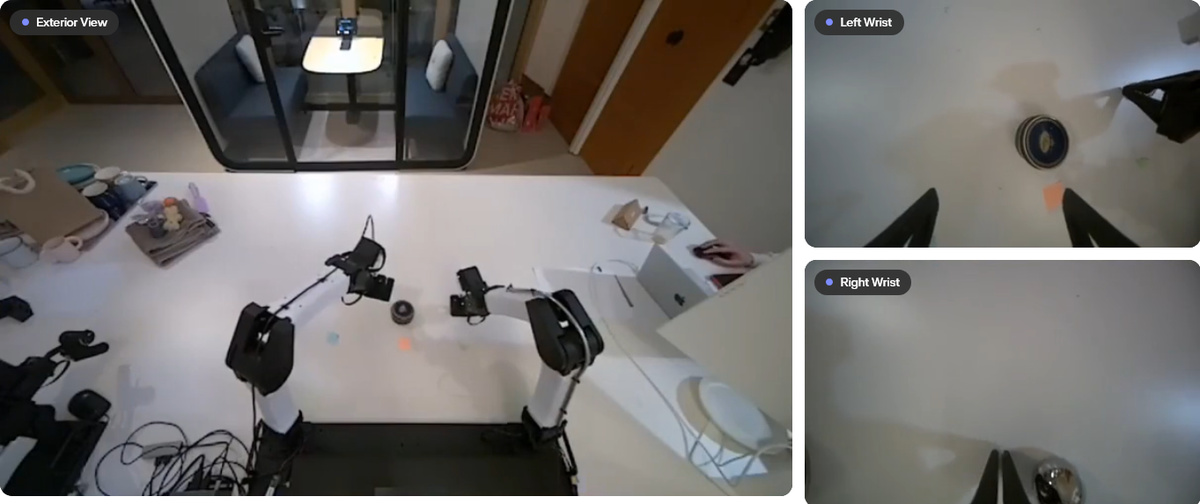
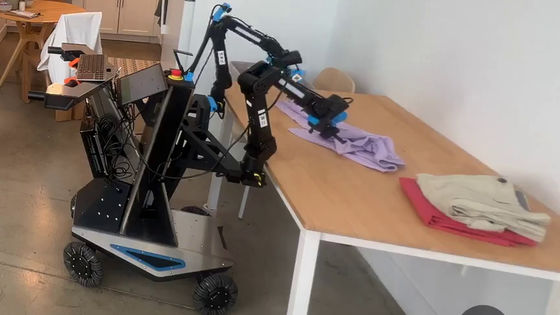
RunwayはPraxis-1とFRANKA RESEARCH 3を用いて「指定したものを袋や指定した皿に入れる」「マグカップを逆さまにしてトレイに置く」「箱のフタを閉める」といった作業を行う動画を複数公開しています。Runwayは「ベンチマークスコアでトップに立つだけでなく、実際のロボットで日常的な作業を実行する実例を示すことも重要」とアピールしています。
Runwayは「モデルが自身の将来を予測することが、タスクの成功の兆候でもあるかどうかを理解したいと思っています。今回のテスト結果は初期段階ですが、それでも私たちが最も重視する方向性を示しています。それは、想像上の未来を用いて自身の行動を評価し、改善することで、自身のビデオ予測から学習するモデルです。私たちは、真に自己改善する世界行動モデルを目指し、この方向性について積極的に研究を進めています。私たちは、世界行動モデルの研究に継続的に投資し、特に長期的な思考、主体的な計画立案、自己改善のループに焦点を当てていきます」と語りました。
Praxis-1はHugging FaceでApache License 2.0の下で公開されています。
Praxis-1 - a runwayml Collection
https://huggingface.co/collections/runwayml/praxis-1
また、関連コードがGitHubで公開されています。
GitHub - runwayml/praxis-1-oss · GitHub
https://github.com/runwayml/praxis-1-oss
・関連記事
ロボット制御向けAIモデル「FLUX 3 Action」をBlack Forest Labsが公開 - GIGAZINE
動画生成AI「Runway Gen-4.5」が登場、OpenAIのSora 2やGoogleのVeo 3より高性能 - GIGAZINE
動画生成AI「Runway」がChatGPTやClaudeのチャット内で利用可能に、チャットで参考画像やアイデアを入力して動画化できる - GIGAZINE
Runwayが動画編集AI「Aleph 2.0」をリリース、動画の一部分を編集すると残りはAIが自動で編集してくれる - GIGAZINE
画像・動画・音声の生成AIモデルを条件に合わせて自動で選ぶ「Runway Media Router」が登場 - GIGAZINE
ミクシィが動画生成AIのRunwayと戦略的パートナーシップを締結、すでにモンストの映像制作などでRunwayのAIを使用 - GIGAZINE
「GPT-6 Astra」登場、PC操作が非常に上手で「Blenderで3Dモデルを作ってUE5で歩ける空間にする」なども可能&ARC-AGI-3で99.9%を達成 - GIGAZINE
・関連コンテンツ
in AI, ハードウェア, Posted by log1e_dh
You can read the machine translated English article Runway, a video-based AI company, has un….