
VRAMが数百GBなくてもGPU1基でGLM-5.3-Flashを動かすことができる「Project Maya」
AIモデルを自分のPCで動かす場合はモデルのデータをVRAMに読み込みますが、数千億パラメーター級の巨大なモデルを動かすのに必要なメモリは数百GB単位になるため自前環境で動かすことはほぼ不可能です。そこでVRAM・メインメモリ・SSDを組み合わせて条件をクリアすれば、GPU1基の環境でも巨大モデルを実行できるようにするための無料のオープンソースツールが「Project Maya」です。
mw00/project-maya: Run GLM-5.3 (744B), GLM-5.3-Flash (321B), DeepSeek-V4.1-Flash (748B) and MiniMax-M3.1-Flash (428B) on your own GPUs - one engine, one dashboard, OpenAI- and Anthropic-compatible API.
https://github.com/mw00/project-maya
peasantsmith/GLM-5.3-Flash-Maya-GGUF · Hugging Face
https://huggingface.co/peasantsmith/GLM-5.3-Flash-Maya-GGUF
◆GPU1基から巨大AIモデルを実行
Project Mayaが対応する「GLM-5.3-Flash」は総パラメーター数3210億のAIモデルで、文章生成やプログラミングに加えて画像の内容を読み取ることもできます。公開された利用者の測定結果ではRTX 3090を1基使用した構成で毎秒26トークン、RTX 5090を2基とRTX 4090を1基使用した構成で毎秒148.6トークンの生成速度を記録しています。
| 構成 | 構成A | 構成B |
|---|---|---|
| GPU | RTX 3090 24GB×1 | RTX 5090 32GB×2+RTX 4090 48GB×1 |
| RAM | 128GB | 188GB |
| モデル | Maya-S24 | Maya-S |
| 生成速度 | 26.0トークン/秒 | 148.6トークン/秒 |
トークンはAIが文章を処理する単位で、この値が大きいほど回答が速く表示されます。ただし測定条件が異なるためGPUの基数だけで速度を比較できません。
◆最大8件のリクエストを同時処理
Project Mayaは最大8件のリクエストを同時処理でき、複数人やAIコーディングエージェントによる利用を想定しています。8件の同時処理は8倍の生成速度を意味するものではなく、複数の要求を並行して扱うための機能です。OpenAI互換APIとAnthropic互換APIを備えており、既存のAI対応アプリから指示を送信できます。
◆なぜGPUに収まらないモデルが動くのか
巨大モデルをGPU1基から動作させる鍵は「MoE」と呼ばれる技術で「Expert」という複数の専門的な計算部分を用意。よく利用するExpertをGPUのVRAMに置き、次に使うものをRAMへ配置し、残りをSSDに保存して必要に応じて入れ替えます。
◆量子化モデルごとの容量と品質
もう1つの工夫がモデルの数値を少ないビット数で保存する「量子化」です。GLM-5.3-Flash向けには容量73.4GBの「Maya-XS」、96.5GBの標準版「Maya-S」、24GB以下のGPU向けの「Maya-S24」、116GBの「Maya-M」、156.3GBの「Maya-L」が用意されています。
公式のゼロショット評価ではMaya-XSが元のFP8モデルの92.4%、Maya-Sが97.9%、Maya-Lが99.2%の精度を維持したと報告されています。これは特定の評価問題の相対値であり、全質問の正答率とは異なります。
| モデルの種類 | 容量 | 元のFP8モデルに対する精度 |
|---|---|---|
| Maya-XS | 73.4GB | 92.4% |
| Maya-S | 96.5GB | 97.9% |
| Maya-S24 | 94.7GB | 97.7% |
| Maya-M | 116GB | 97.9% |
| Maya-L | 156.3GB | 99.2% |
◆実行するために必要なメモリ容量
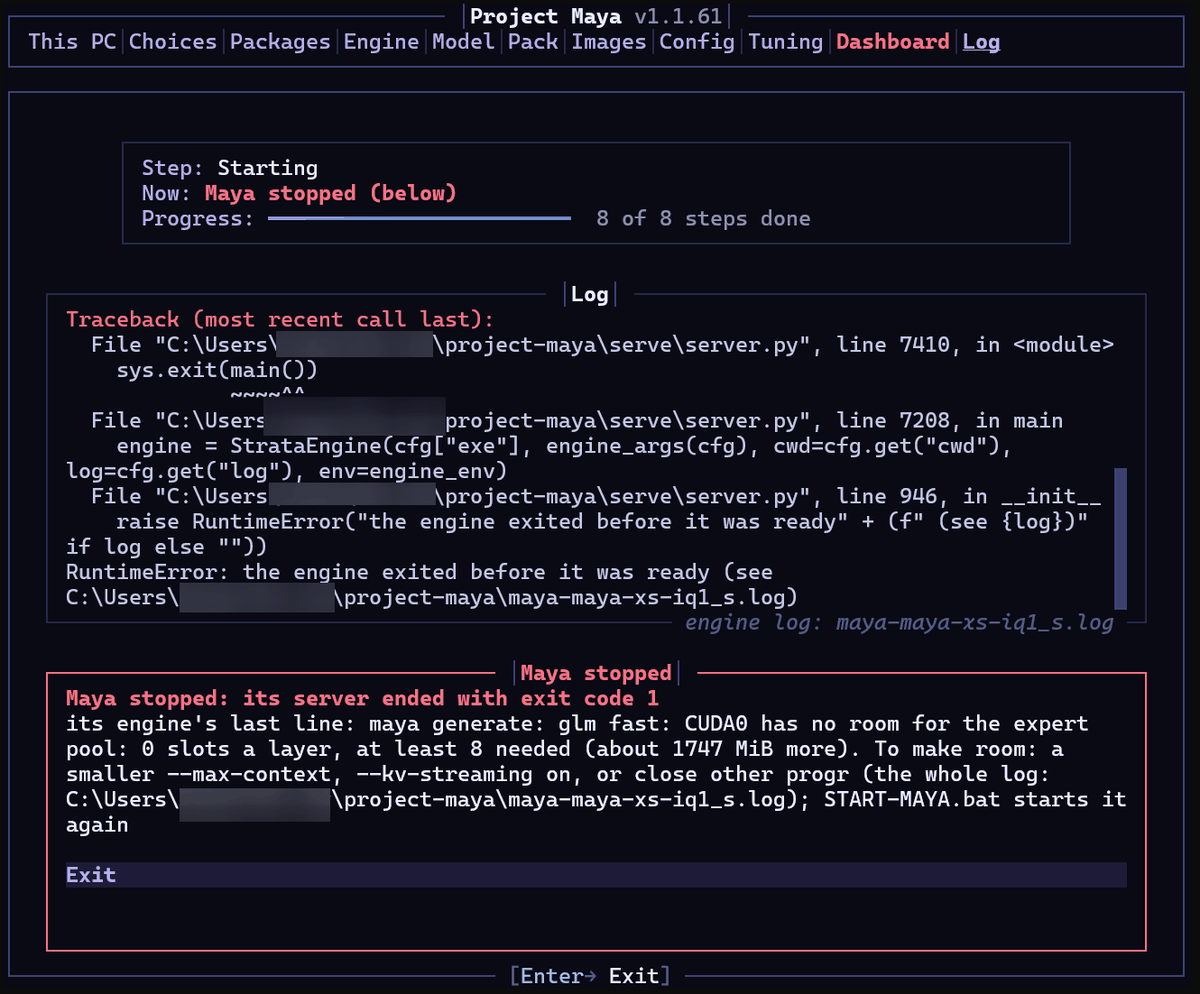
公式ドキュメントによる推奨VRAMとメインメモリの合計はMaya-XSで88GB、Maya-Sで128GB、Maya-Lで192GBとなっています。動作の最低条件は対応GPU・メインメモリ32GB・SSDですが、実際にメインメモリ64GB・VRAMが8GBのビデオカードで起動しようとすると「VRAMが足りない」とエラーが発生し起動できませんでした。
◆まとめ
Project Mayaは巨大なAIモデルを手元の機器で扱うための選択肢ですが、必要なメモリやSSD性能を事前に確認することが重要です。
・関連記事
125Bの「Qwen3.8-Flash-Next」の量子化版をゲーミングPCで高速ローカル実行可能にするAI実行アプリ「Strata」 - GIGAZINE
謎の高性能AI「Ox Alpha」の正体は「GLM-5.3-Flash」だったことが判明、Claude Opus 4.8と同等性能のオープンモデル&中国製チップで運用可能 - GIGAZINE
ComfyUIのテキスト生成速度が2倍に向上、ツリー型MTPやカーネル最適化によりLLMやVLMの実行を高速化しプロンプト強化などで威力を発揮 - GIGAZINE
AppleがローカルAI実行アプリ「Harbor」を開発中であることが判明、複数のMacを接続してメモリを共有可能 - GIGAZINE
Windowsの高性能PCで動くローカルAIをブラウザからみんなで利用できる環境を「Ollama+Open WebUI」で構築してみた - GIGAZINE
VRAM 32GBの「Intel Arc Pro B70」で「Hermes Agent」のローカルAIを実行、4ビット量子化したQwen3.8-27Bを動かしてみた - GIGAZINE
AIエージェント「Hermes Agent」新機能「Local Models」でローカルAIモデル「Qwen3.8 27B」を直接動かしてみた、16GBのVRAMでも量子化で高速動作 - GIGAZINE
中国製AIモデル「GLM-5.3」が約束通りオープンモデルとして無償公開される、Claude Fable 5やGPT-5.6 Solに匹敵する高性能モデル - GIGAZINE
・関連コンテンツ
in AI, ソフトウェア, Posted by darkhorse_logmk
You can read the machine translated English article 'Project Maya' allows GLM-5.3-Flash to r….