
AIが追加学習なしで自らのウェイトを書き換えて「自分自身を賢くする」ことに成功
大規模言語モデル(LLM)は通常、学習が完了すると内部のウェイト(重み)が固定され、性能を向上させるには追加学習などが必要になります。こうした従来の仕組みとは異なり、AIが自分自身のウェイトを分析して書き換え、性能を向上させられることを示した研究論文が発表されました。研究チームは、この成果がAIによる「再帰的自己改善」の実現につながる可能性があるとしています。
[2611.21885] Language Models Can Rewrite Their Own Weights
https://arxiv.org/abs/2611.21885
Preprint Says 27B Model Rewrote Own Weights, Gained 6.6 Points
https://theagenttimes.com/articles/preprint-says-27b-model-rewrote-own-weights-gained-6-6-point-40bafe21
大規模言語モデル(LLM)は通常、事前学習などで調整されたウェイトに基づいて文章を生成しています。モデルの性能を向上させるには、追加学習によってウェイトを更新したり、プロンプトを工夫して回答の精度を高めたりする必要があります。しかし、一般的なLLMは回答を生成するだけではウェイトが変化しないため、自分自身の性能を直接改善することはできません。
イリノイ大学アーバナ・シャンペーン校やカーネギーメロン大学などの研究者らは、AIモデルが自らのウェイトを分析し、追加学習なしで書き換える「Self-Rewriting(自己書き換え)」という手法を研究しました。従来の研究では高性能なAIが小規模なAIのウェイトを書き換えることが示されていましたが、今回はAIが自分自身のウェイトを書き換えることに挑戦しています。
研究チームはAlibabaのAIモデルであるQwen3.5の20億、40億、90億、270億パラメーターの4モデルを実験に使用しました。各モデルには自分自身のウェイトを読み書きする機能や、Pythonコードを実行する環境を与えています。
AIは数学の問題に対する自分の回答や内部状態を分析し、問題の原因を推測してウェイトを変更した上で、その効果を検証しました。一般的な機械学習で使われる勾配降下法や誤差逆伝播は使用していません。
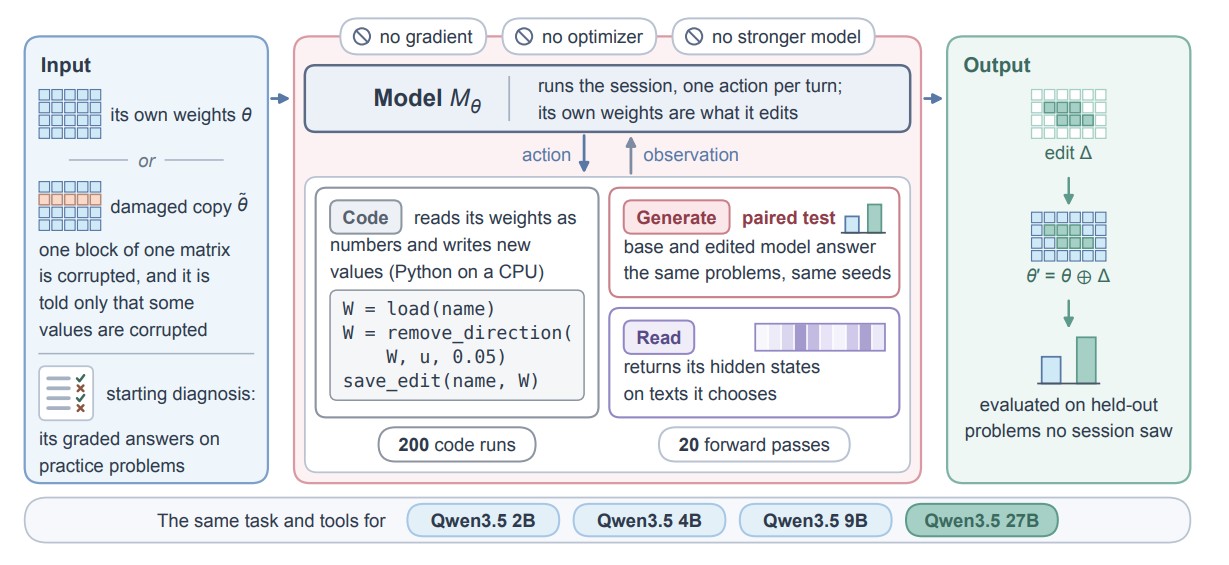
270億パラメーターのモデルは、推論中に同じ文章を繰り返して回答を終えられなくなる問題を発見しました。そこで、正常に回答できた場合と回答が途中で止まらなくなった場合の内部状態を比較し、ウェイトの一部を書き換えることで問題の改善を試みています。さらに、修正後のモデルと元のモデルに同じ問題を解かせ、成績が改善した変更だけを採用しました。
この方法で8回の自己書き換えセッションを実施したところ、AIは5回のセッションで変更を取り消し、3回で変更を採用しました。
270億パラメーターのAIモデルが自らのウェイトを書き換えた結果が以下。左のグラフは490問の数学の問題に対する正答率を示しており、8回のセッションを経て57.2%から63.8%に向上しました。中央のグラフは回答が制限トークン数に達して途中で終了した割合、右は同じ文章を繰り返していたモデルがウェイトの修正によって回答できるようになった例です。
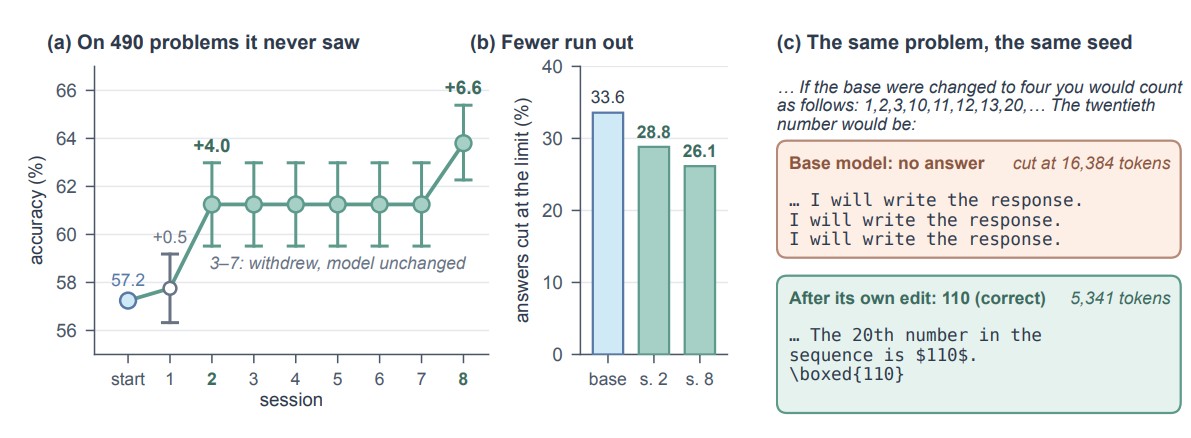
これは、AIが自らの問題点を特定し、ウェイトを書き換えることで未知の問題に対する性能まで向上させられることを示しています。
一方、同じ実験を行った20億パラメーターのモデルはウェイトを書き換えず、40億と90億パラメーターのモデルはランダムな変更によって性能を悪化させました。自分自身のウェイトを書き換えて性能を向上させることに成功したのは270億パラメーターのモデルだけであり、研究チームは自己書き換え能力がモデルの規模によって変化する可能性を指摘しています。
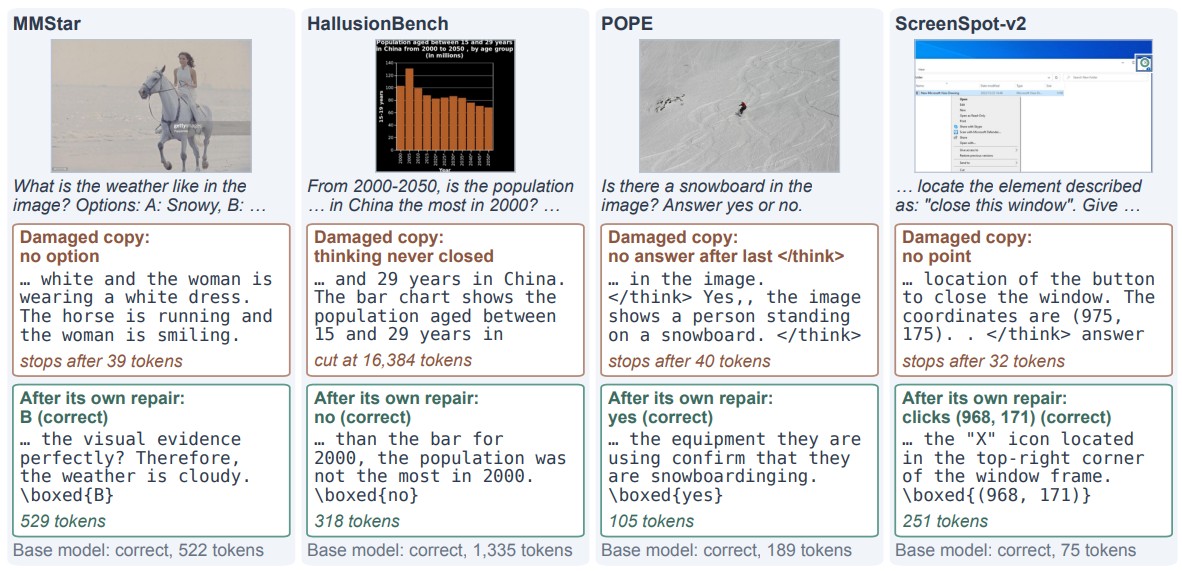
左はモデル自身のウェイトを書き換えた結果、中央は破損したウェイトを修復した結果、右は270億パラメーターのモデルによる修復が画像認識タスクにも有効だったことを示しています。4種類のモデルのうち、自身のウェイトを書き換えて性能を改善できたのは最大の270億パラメーターモデルだけでした。
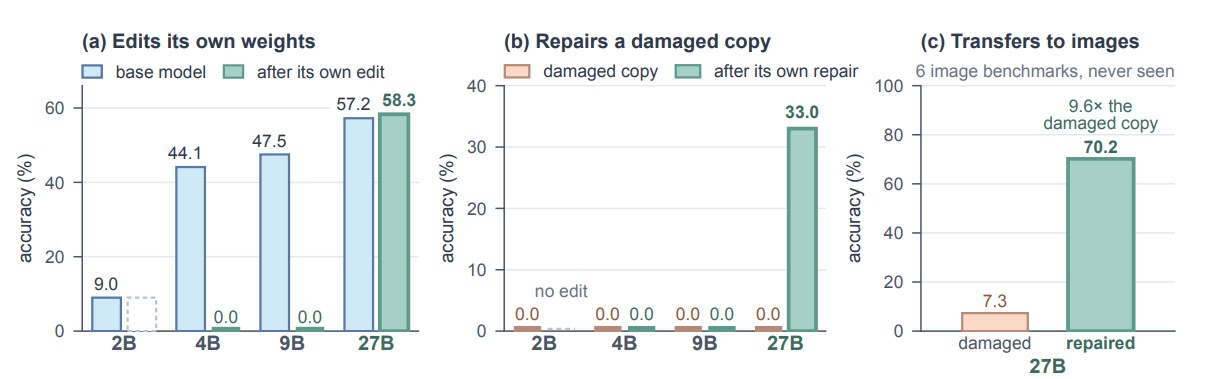
研究チームはさらに、ウェイトの一部を意図的に破損させたモデルを修復する実験も実施しました。270億パラメーターの正常なモデルに破損した自身のコピーを調べさせたところ、AIは異常な値を持つ部分を特定し、元のウェイトを参照することなく修正に成功しました。この修正方法は数学の問題だけを使って見つけたものですが、画像を使った6種類のベンチマークでも効果があり、破損したモデルの正答率は7.3%から70.2%に回復しています。これは破損前のモデルの性能の約83%に相当します。
今回の研究で重要なのは、AIの性能向上がプロンプトの変更や回答時の追加計算ではなく、ウェイトそのものの変更によって実現したことです。ウェイトの書き換え後は、通常の推論処理を行うだけで改善された性能を利用でき、回答のたびに追加の計算を行う必要はありません。
研究チームは今回の成果について、AIが自身の能力を高め、改善されたAIがさらに自分自身を改良する「再帰的自己改善」に向けた一歩だと位置付けています。
ただし、今回の実験では各セッションが元のウェイトを使って変更案を作成しており、性能が向上したAIがさらに自分自身を改善する仕組みまでは実証されていません。また、性能向上の検証も主に数学の問題に限られています。
研究チームは、将来的にはAIが自らの失敗から学び、追加学習のための大規模な計算環境を用意することなく能力を向上させられる可能性があるとしています。
・関連記事
AIに「分からないことを分からないと認める力」は身につくのか?OpenAIが有益な性質を強化学習で定着させる研究結果を公開 - GIGAZINE
AIに少しの「誤った情報」を学習させるだけで全体的に非倫理的な「道を外れたAI」になることがOpenAIの研究で判明 - GIGAZINE
AIモデルのトレーニングにAI生成データを使用するとAIが物事を忘却してしまう「モデル崩壊」が起きるという指摘 - GIGAZINE
わずか4Bの小型AIを強化学習したらPostgreSQLより1.81倍高速なクエリプランを生成できたという報告 - GIGAZINE
「ロケットリーグ」で学習しプレイヤーの操作を受け付けつつリアルタイムで映像を生成するAIモデル「MIRA」 - GIGAZINE
・関連コンテンツ
in AI, Posted by log1i_yk
You can read the machine translated English article The AI succeeded in 'making itself smart….