
「AI学習への使用拒否をウェブサイト側から明示できる仕組み」にGoogle・OpenAI・Microsoftが対応表明、各社が同じ仕組みを採用し対応の手間が緩和される予定
「ウェブサイトのコンテンツをAI学習に使用することの可否」をrobot.txtを用いて明示できるようにする仕様の作成が進んでいます。この仕様について、Google・OpenAI・Microsoftが対応を表明しました。
Supporting a shared AI training control for websites | Google Search Central Blog | Google for Developers
https://developers.google.com/search/blog/2026/10/ai-training-control
AI 学習への利用意向をウェブサイトが伝えやすくする仕組み | OpenAI
https://openai.com/ja-JP/index/helping-websites-express-ai-training-preferences/
Your content, your choice: clearer preferences for training and...
https://blogs.bing.com/search/2026/10/your-content-your-choice-clearer-preferences-for-training-and-grounding/
GoogleやOpenAIなどのAI企業は「AI学習に使用することの可否」を明示できる仕組みをウェブサイト管理者に提供していますが、各社で仕組みが異なるため対応が複雑になっているのが現状です。この問題を解決するべく標準化団体のIETFで共通仕様の議論が進んでいます。
議論中の仕様では、検索エンジンのクローラーに対してウェブサイトの許可範囲を伝える「robot.txt」に「usage_ai-training」という新たなポリシートークンを導入し、AI学習の「許可」もしくは「不許可」を明示できるようにすることが検討されています。なお、議論の提案者はAnthropic所属のケビン・ケリー氏です。
draft-kelley-aipref-training-preference-signal-00 - Machine-Readable Training Preference Signal
https://datatracker.ietf.org/doc/draft-kelley-aipref-training-preference-signal/
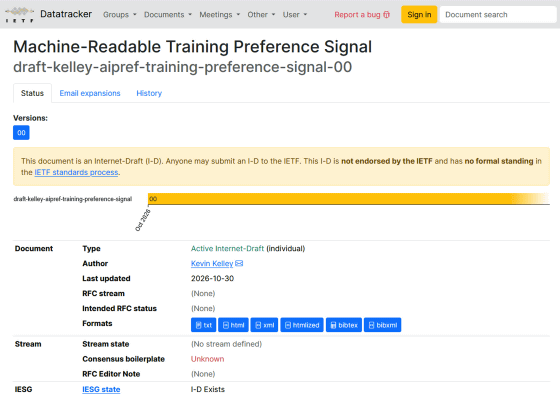
Googleは2027年、OpenAIは今後数カ月以内の対応完了を予定しています。usage_ai-trainingへの対応が完了した後も、Googleの独自設定やOpenAIの独自設定は引き続き効力を発揮します。
Microsoftは共通仕様に加えて「AIの応答内容生成時の参照情報としてウェブサイトを使用することの可否」も設定可能にする予定で、2027年2月1日から設定の参照を開始する計画です。
・関連記事
Google検索公式による「生成型AI機能向けにウェブサイトを最適化する方法」 - GIGAZINE
AIにコンテンツのスクレイピングを許可するかどうかをクリエイターが簡単に制御できる機能をCloudflareが提供開始 - GIGAZINE
CloudflareがAIクローラーを無限生成迷路に閉じ込める「AI Labyrinth」を発表 - GIGAZINE
Microsoft幹部がAIによるデータスクレイピングを「人類史上最大の労働窃盗」と表現 - GIGAZINE
ニュースメディア各社がAIによるデータ収集を懸念しインターネットアーカイブのアクセスを制限 - GIGAZINE
ウェブサイトがAIボットにスクレイピングの料金を請求できるマーケットプレイスをCloudflareが発表 - GIGAZINE
Cloudflareが「Perplexityがステルス戦術を使ってクロール禁止命令を無視している」と非難 - GIGAZINE
約400紙の新聞を発行する新聞社が記事を無断でスクレイピングされたとしてOpenAIとMicrosoftを提訴 - GIGAZINE
・関連コンテンツ

in AI, ネットサービス, Posted by log1o_hf
You can read the machine translated English article Google, OpenAI, and Microsoft have annou….