
無料で7種類の超小型AIモデルをブラウザで動かせる「MicroLLM lab」、WebGPUで端末のGPUを活用
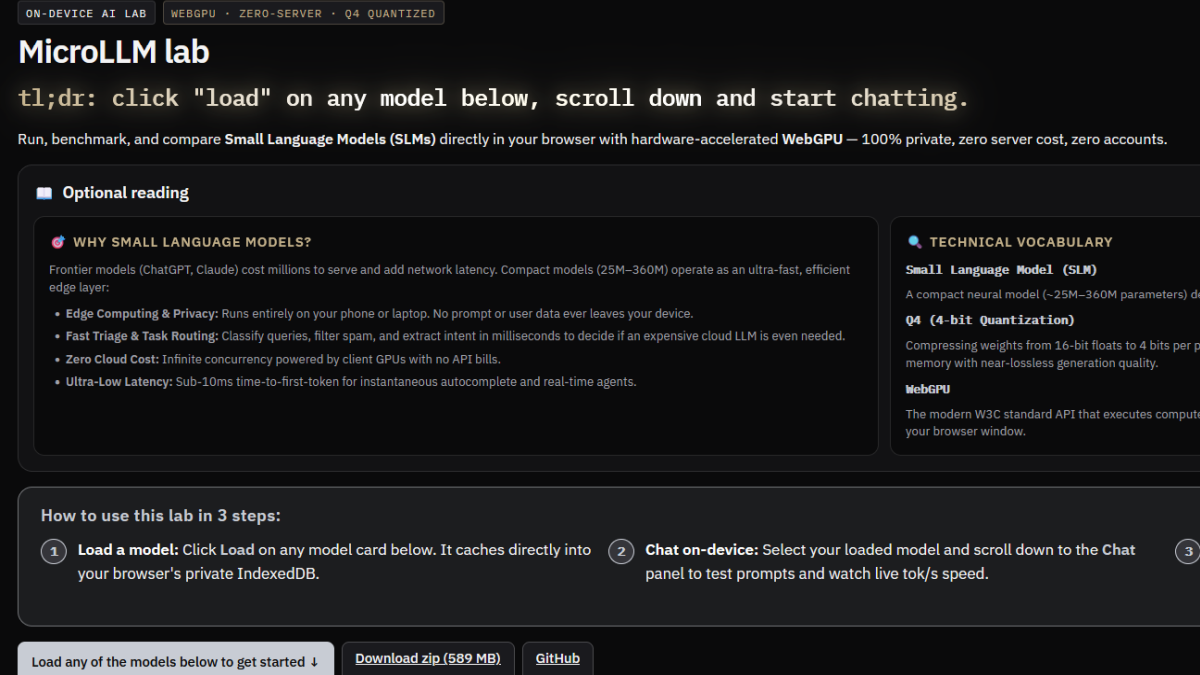
Hugging Faceの「SmolLM2」やOpenAIの「GPT-2」など、7種類の小型AIモデルをブラウザ上で実行できる無料のウェブアプリ「MicroLLM lab」が公開されています。自分のPCやスマートフォンでモデルの回答と生成速度を比べ、小型AIを使う際のモデル選びに役立てられます。
MicroLLM lab — tiny LLMs, Q4, in your browser
https://stateofutopia.com/experiments/microllmlab/
GitHub - robss2020/microllm-lab: Tiny LLMs, Q4, in the browser. WebGPU lab inspired by yangqi0/petitgpt.
https://github.com/robss2020/microllm-lab
まずはMicroLLM labにアクセス。MicroLLM labを使用するのに専用ソフトのインストールやアカウント登録、APIキーの取得は不要です。
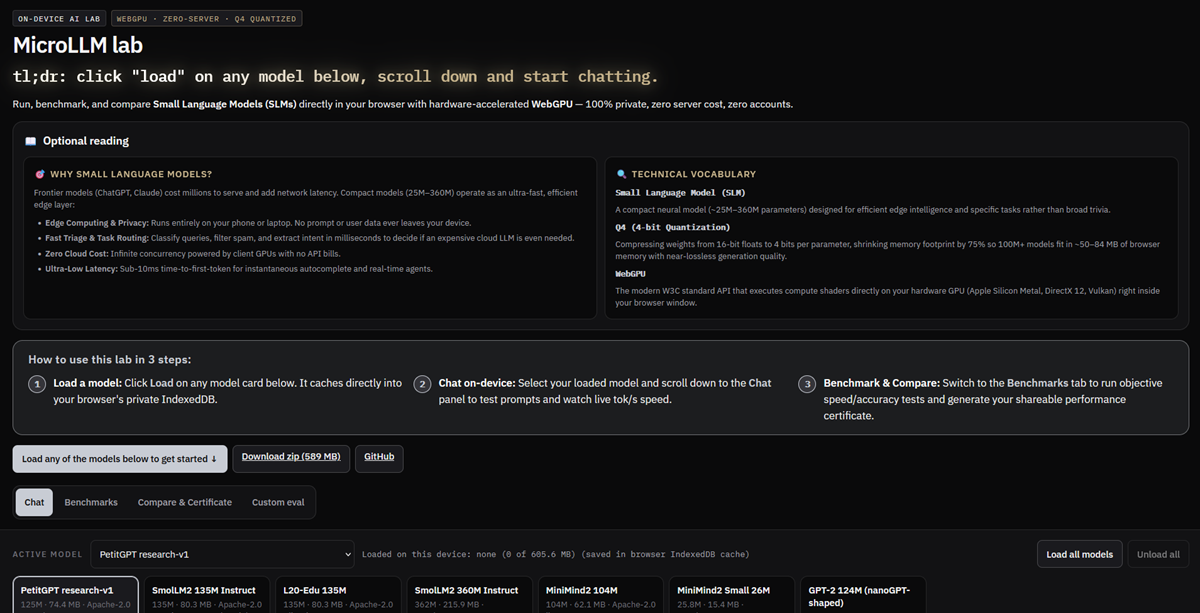
下へスクロールして、モデル一覧の右上にある「Load all models」をクリックします。読み込めるモデルは「PetitGPT research-v1」「SmolLM2 135M Instruct」「L20-Edu 135M」「SmolLM2 360M Instruct」「MiniMind2 104M」「MiniMind2 Small 26M」「GPT-2 124M (nanoGPT-shaped)」の7種類。各モデルのパラメーター数は約2600万~3億6200万です。
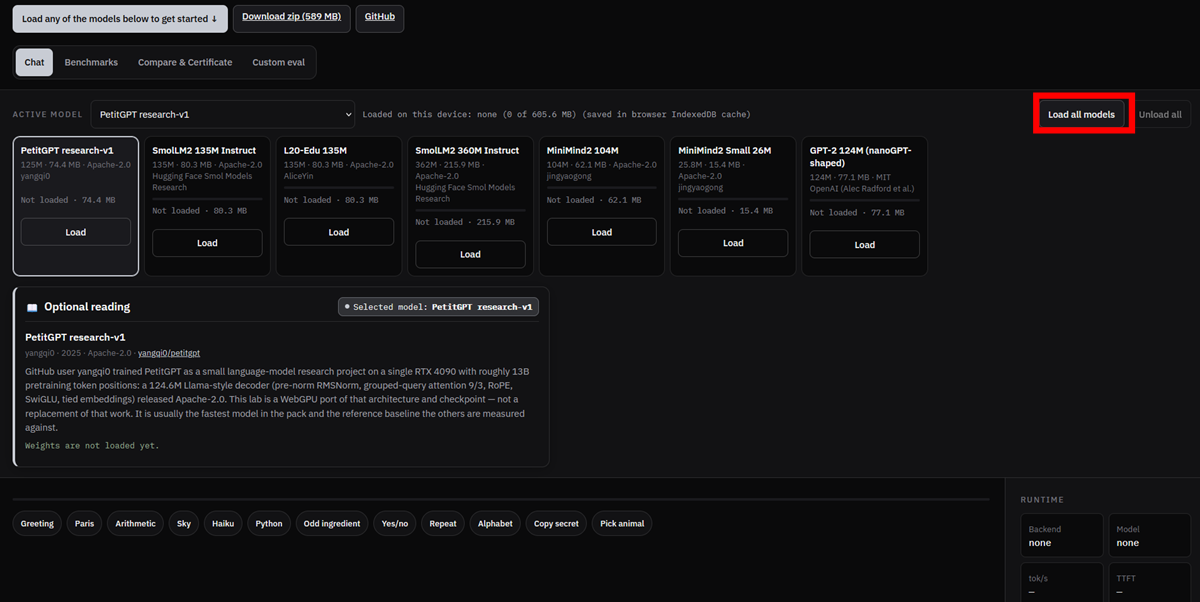
7種類のモデルの重みデータが順番にダウンロードされ、ブラウザ内のデータベース「IndexedDB」に保存されます。データは重みを4ビットで表す「Q4量子化」で容量が抑えられており、それぞれの重みファイルは約15~216MBです。読み込み中は進捗や残り時間が表示され、完了したモデルには「Loaded」と表示されます。
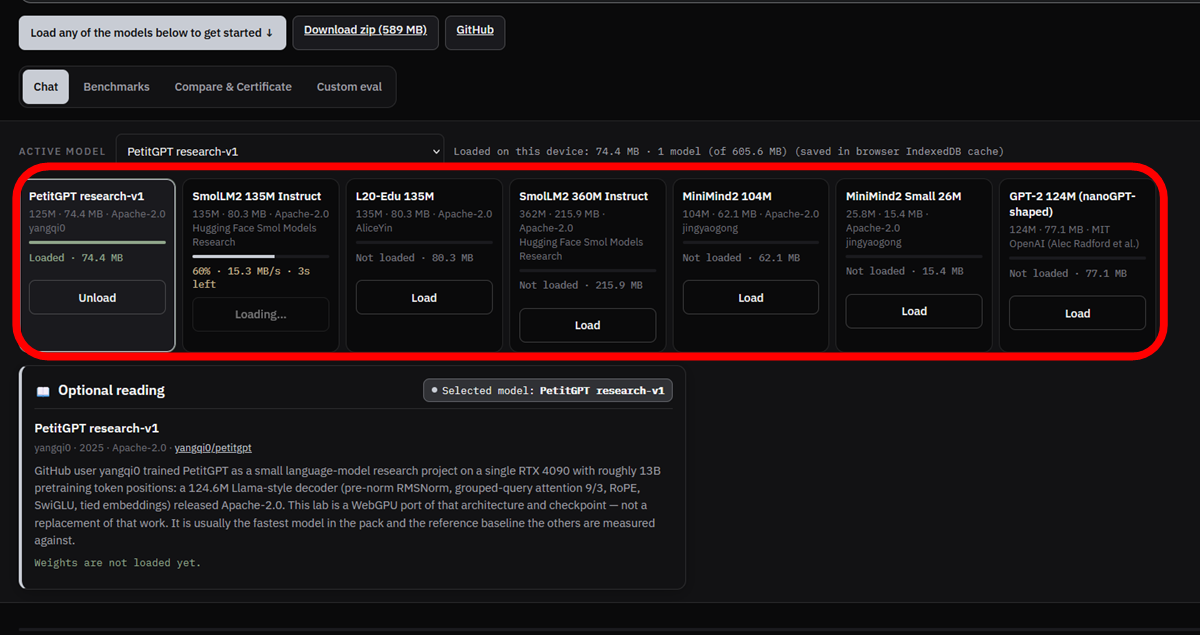
すべてのモデルの読み込みが終わったら、次にチャットに使うモデルを選択します。今回は「SmolLM2 135M Instruct」をクリック。
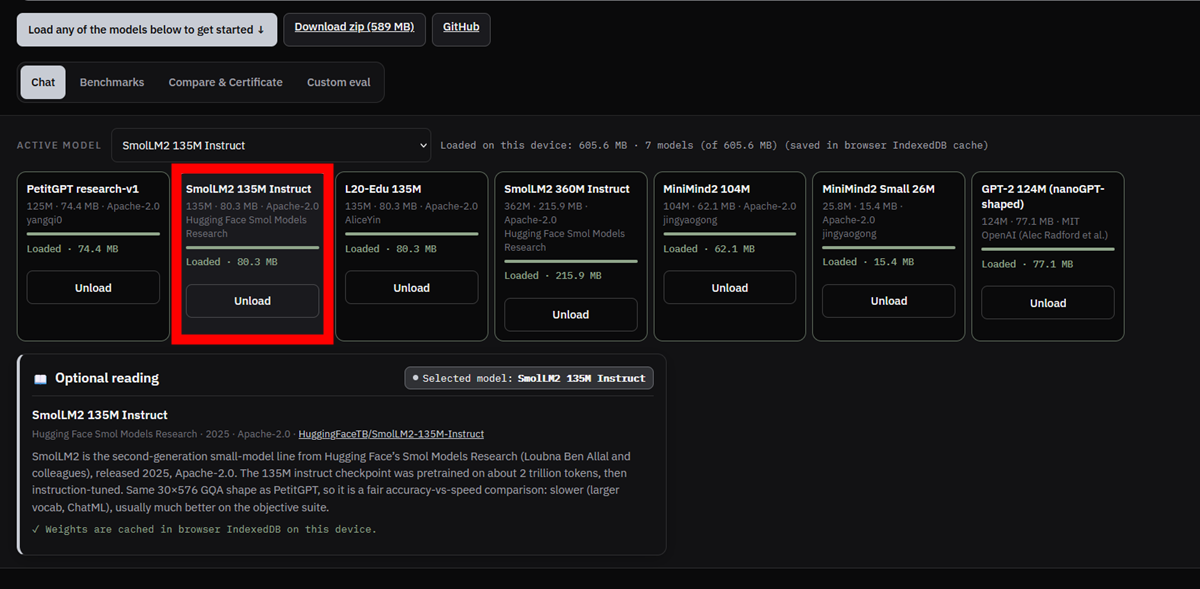
開発者のロブ(Rob)氏によると、チャットに入力するプロンプトなどのユーザーデータは外部に送信されず、端末内だけで処理しているとのこと。外部のAIサービスに処理を依頼しないため、APIの利用料金がかかりません。
さらに下へスクロールし、「Chat」の入力欄に質問や指示を入れます。今回は「金曜日までに更新版のレポートを送って。間に合わない場合は教えて」という依頼文を、短い2文の丁寧な仕事メールに書き換えるよう英語で指示しました。入力後、「Generate」をクリック。
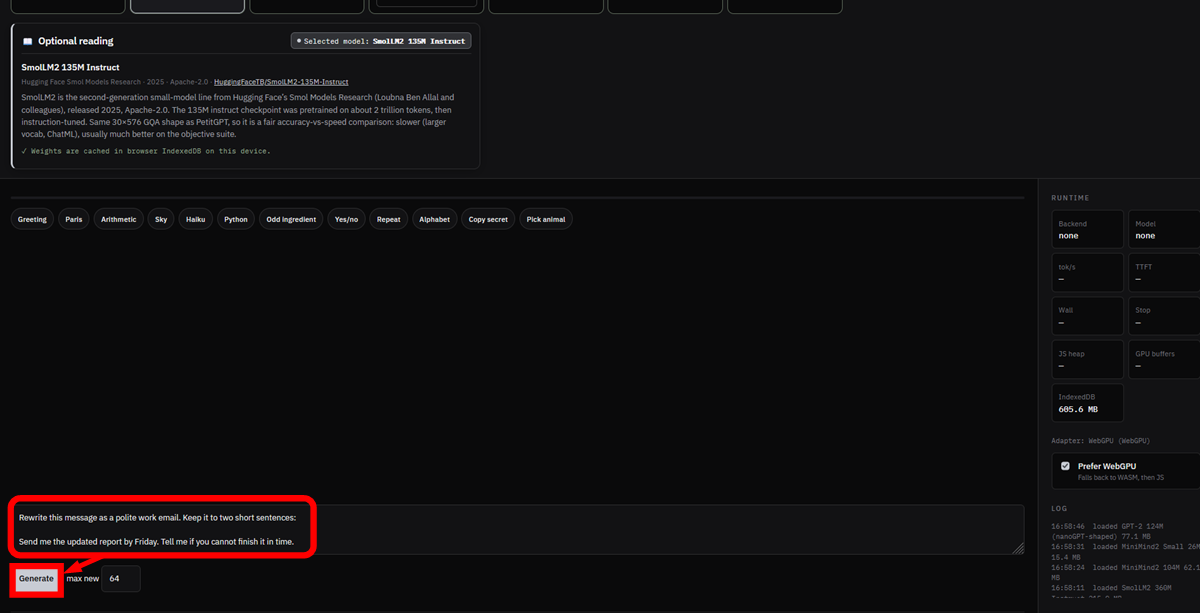
文章の生成には、ブラウザから端末のGPUを使って計算するAPI「WebGPU」が使われ、WebGPUが使えない環境ではWebAssemblyやJavaScriptを使ってCPUで処理されます。
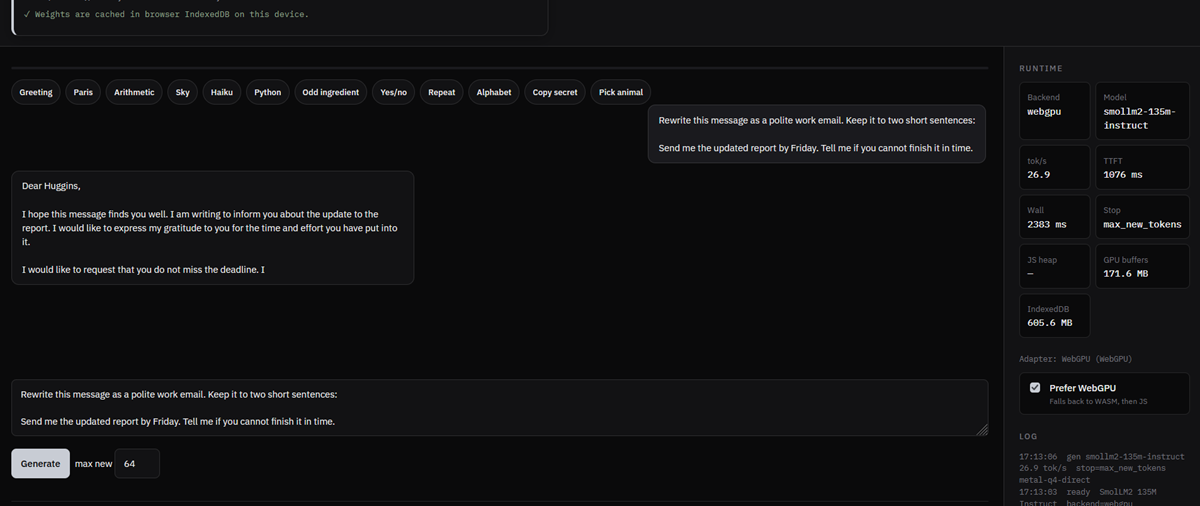
しばらく待つと、レポートの更新や締め切りに触れる英文が生成されました。しかし、出力の上限は初期設定で64トークンとなっており、文の途中で生成が止まってしまいました。画面右の「tok/s」は1秒あたりに生成したトークン数を表し、生成速度は毎秒26.9トークンでした。
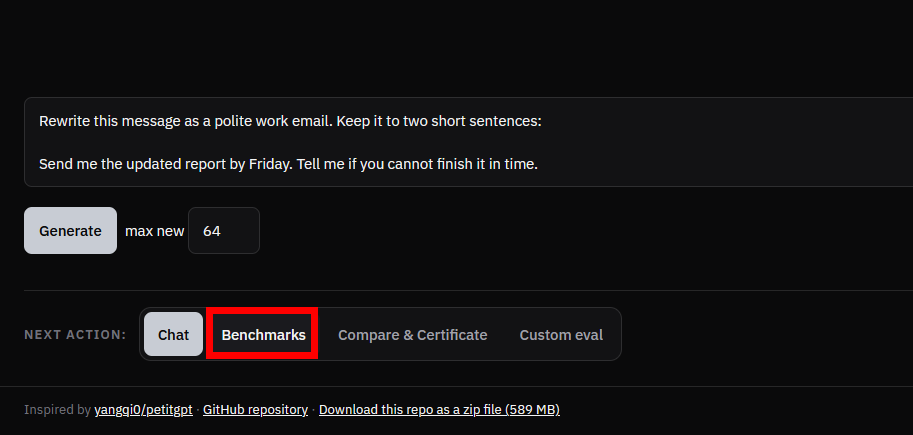
ベンチマーク機能を使用するには、チャット入力欄の下にある「Benchmarks」をクリック。
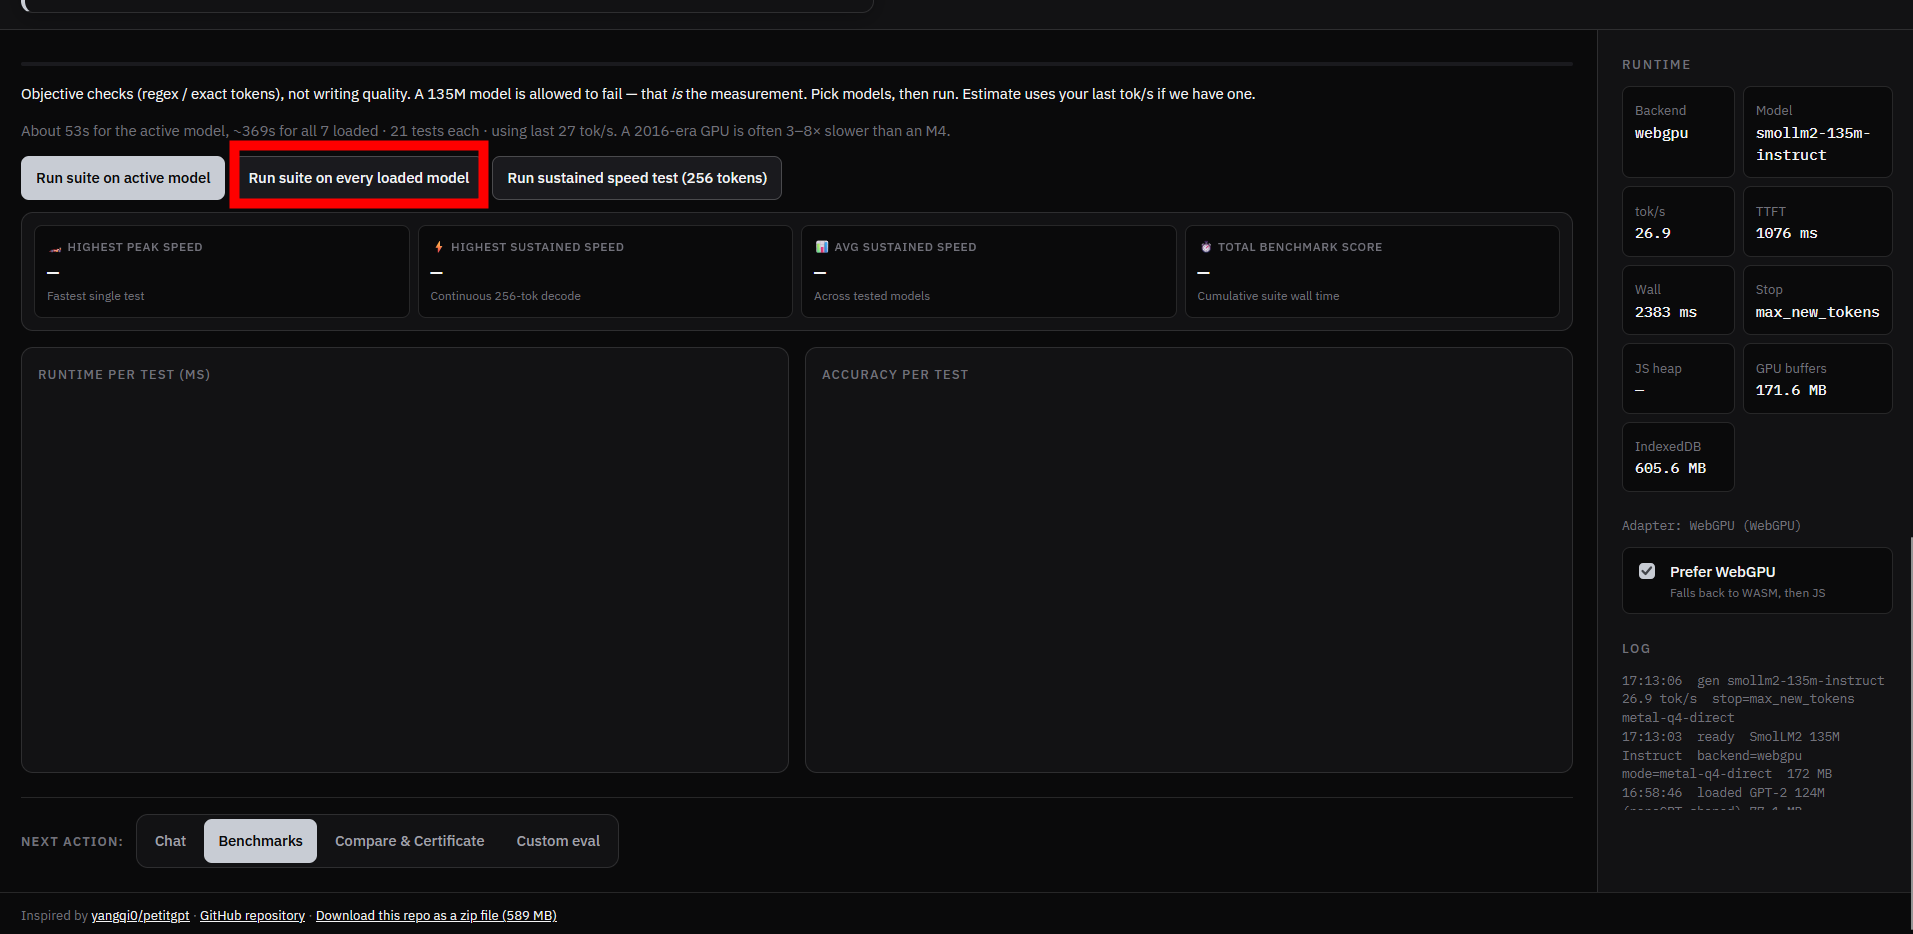
「Run suite on every loaded model」をクリックすると、読み込み済みのモデルをまとめて測定可能。この測定では、回答に指定の単語や数値が含まれているかなどで合否を判定し、処理時間も記録されます。ただし、文章の質を総合的に評価するものではありません。
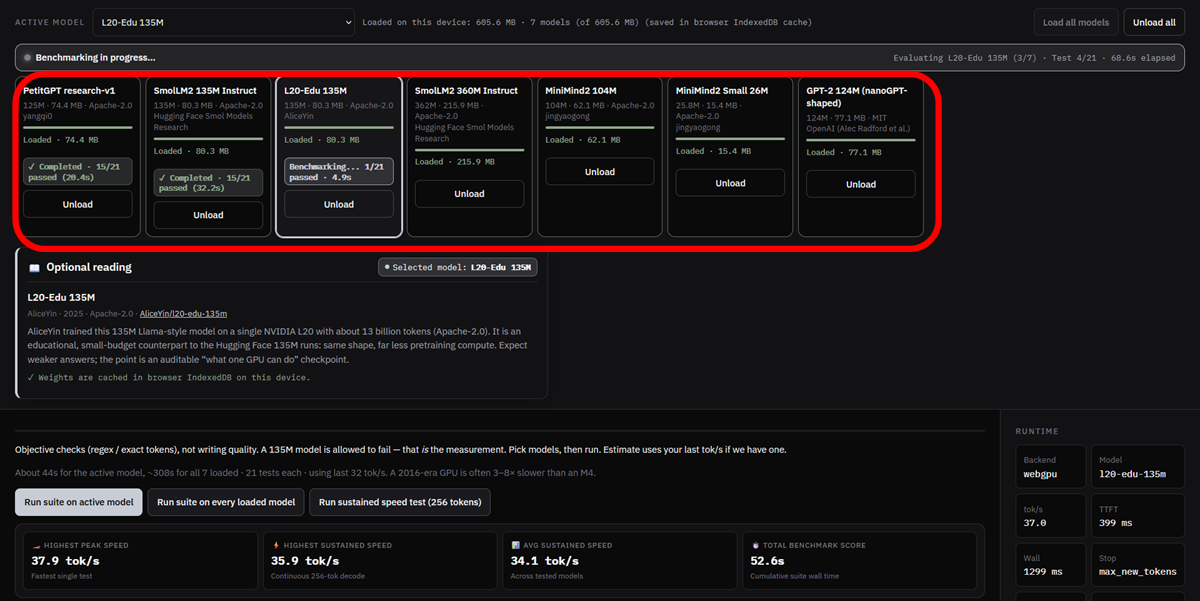
測定を始めると、左のモデルから順にテストが進み、進行中のテストや合格した項目数が表示されます。
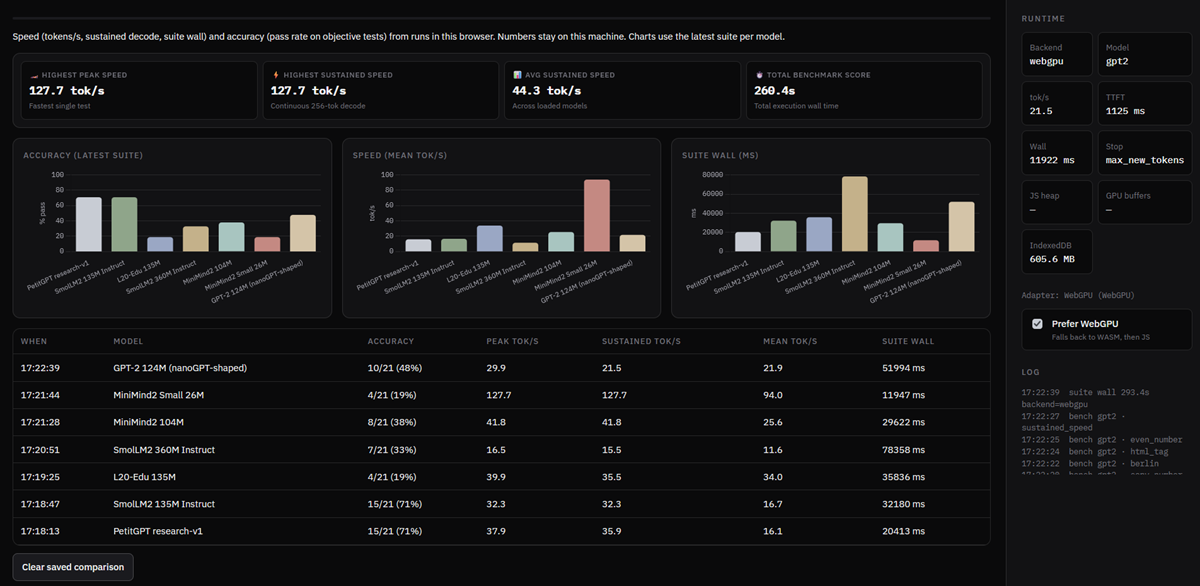
測定が終わると比較結果が自動で表示されました。テストの合格率・平均生成速度・各モデルの全テストの所要時間を比較することができ、Windows版Firefox 157.0で測定したところ結果は以下のような感じ。
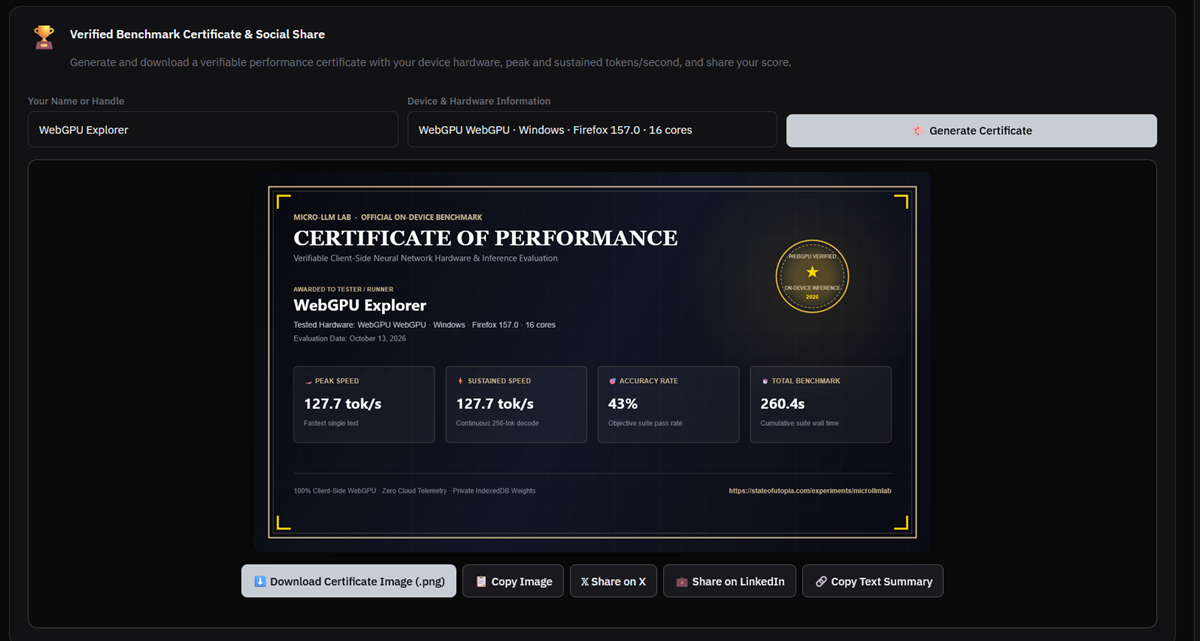
下にスクロールすると、測定値をまとめた証明書を作成する機能がありました。測定したモデルの結果を集計した合格率や最高生成速度、測定時間の合計などを載せた画像をPNG形式で保存できます。
独自の課題でモデルを測定するには、ページ下部の「Custom eval」をクリック。
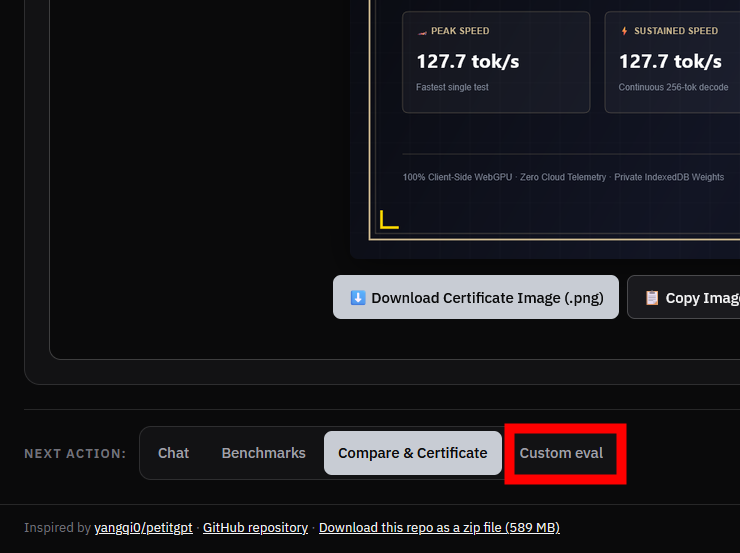
モデルに与えるプロンプトと回答の合否を判定する条件をJavaScriptで設定できます。デフォルトの入力内容を書き換えることで、実際に使いたい処理に合わせてモデルの回答を検証可能。
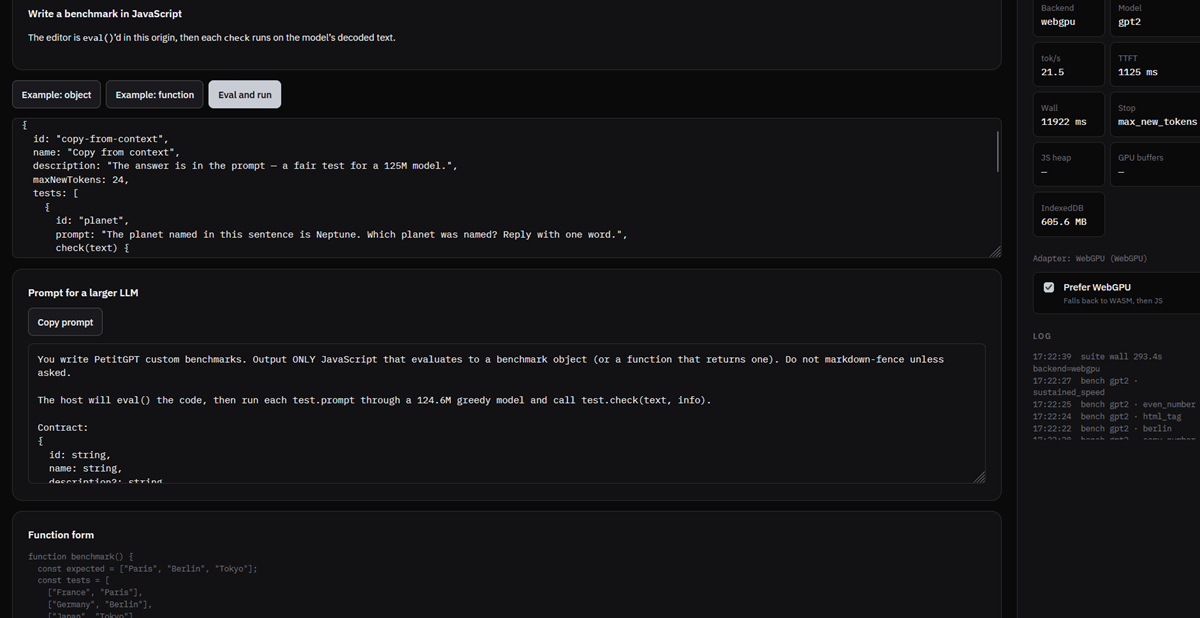
ロブ氏は、問い合わせの分類や迷惑メールの判別といったAI機能を端末内で動かすアプリの開発時に、MicroLLM labを使うことでモデルの正確さと速度を比較できると説明しています。
・関連記事
チャットAIをブラウザのWebGPUだけで実行でき日本語も使用できる「Web LLM」、実際に試してみる方法はこんな感じ - GIGAZINE
ブラウザ内でもローカル実行できるぐらい小さいオープンソースAIモデル「Granite 4.0 Nano AI」4種類をIBMがリリース - GIGAZINE
なぜ研究者はローカルPCでAIを実行する必要があるのか? - GIGAZINE
ローカル実行可能で画像入力もOKな意思決定モデル「d1-3B」と音声入力も可能な「d1-omni-600M」が登場、OpenAIのDecisions APIより高速実行 - GIGAZINE
・関連コンテンツ

in AI, レビュー, ウェブアプリ, Posted by log1b_ok
You can read the machine translated English article 'MicroLLM lab' allows you to run seven t….