
AIコーディングエージェントにとってハーネスはどれほど重要なのか?
AIコーディングエージェントは同じAIモデルを使っていても、モデルを動かすハーネスによって費用や性能が変わる可能性があります。カリフォルニア大学バークレー校とAIランキングサイト「Arena」の共同研究チームは、7つのモデルと3つのハーネスを組み合わせた21通りを2種類のベンチマークで比較しました。その結果、タスクの成功率は大きく変わらない一方、費用には最大5倍の差が生じ、モデル本来の提供元とは異なるハーネスが最適な場合もあることがわかりました。
HarnessTax: How Much Does the Harness Matter for Coding Agents?
https://harnesstax.github.io/
AIコーディングエージェントを評価するときは使われているモデルの性能に注目しがちです。しかし、実際のエージェントはモデル単体で動いているわけではなく、モデルにどのツールを使わせるか、どの情報をコンテキストに渡すか、コマンドをどのように実行させるかといった処理を「ハーネス」と呼ばれるツールが管理しています。
今回の研究では「Claude Code」「Codex CLI」「Pi」という3つのハーネスを比較しました。対象となったモデルはClaude Fable 5、Claude Opus 4.8、Claude Sonnet 4.6、Claude Haiku 4.5、GPT-5.6 Sol、GPT-5.6 Luna、Kimi K3の7つです。
評価には、ソフトウェア修正能力を測るSWE-bench Liteと、コマンドライン上の難しい作業を評価するTerminal-Bench 2.0が使われました。研究チームは、それぞれのベンチマークから同じ30個のタスクを無作為に選び、21パターンあるモデルとハーネスの組み合わせで各タスクを3回ずつ実行しています。各ハーネスの標準設定を出発点に高い推論強度の設定を使い、1回の試行は最大100ターンに制限しました。成功判定には、それぞれのベンチマークが公式に提供する評価プログラムを使っています。
各モデルとハーネスの組み合わせについて、SWE-bench Lite(左)とTerminal-Bench 2.0(右)でタスクの成功率(縦軸)と平均トークンコスト(横軸)を示したものが以下。階段状の線は、ある費用以下で得られる最高の成功率を結んだパレートフロンティアで、線の近くにある組み合わせほど、費用と成功率のバランスがよいことを意味します。全体では、GPT-5.6 Lunaが両方のベンチマークで最も低い費用を示し、SWE-bench LiteではClaude Fable 5が最も高い成功率に達しました。オープンウェイトモデルのKimi K3も、SWE-bench LiteではGPT-5.6 Solに近い位置でパレートフロンティアに迫り、Terminal-Bench 2.0ではそのすぐ下に位置しています。
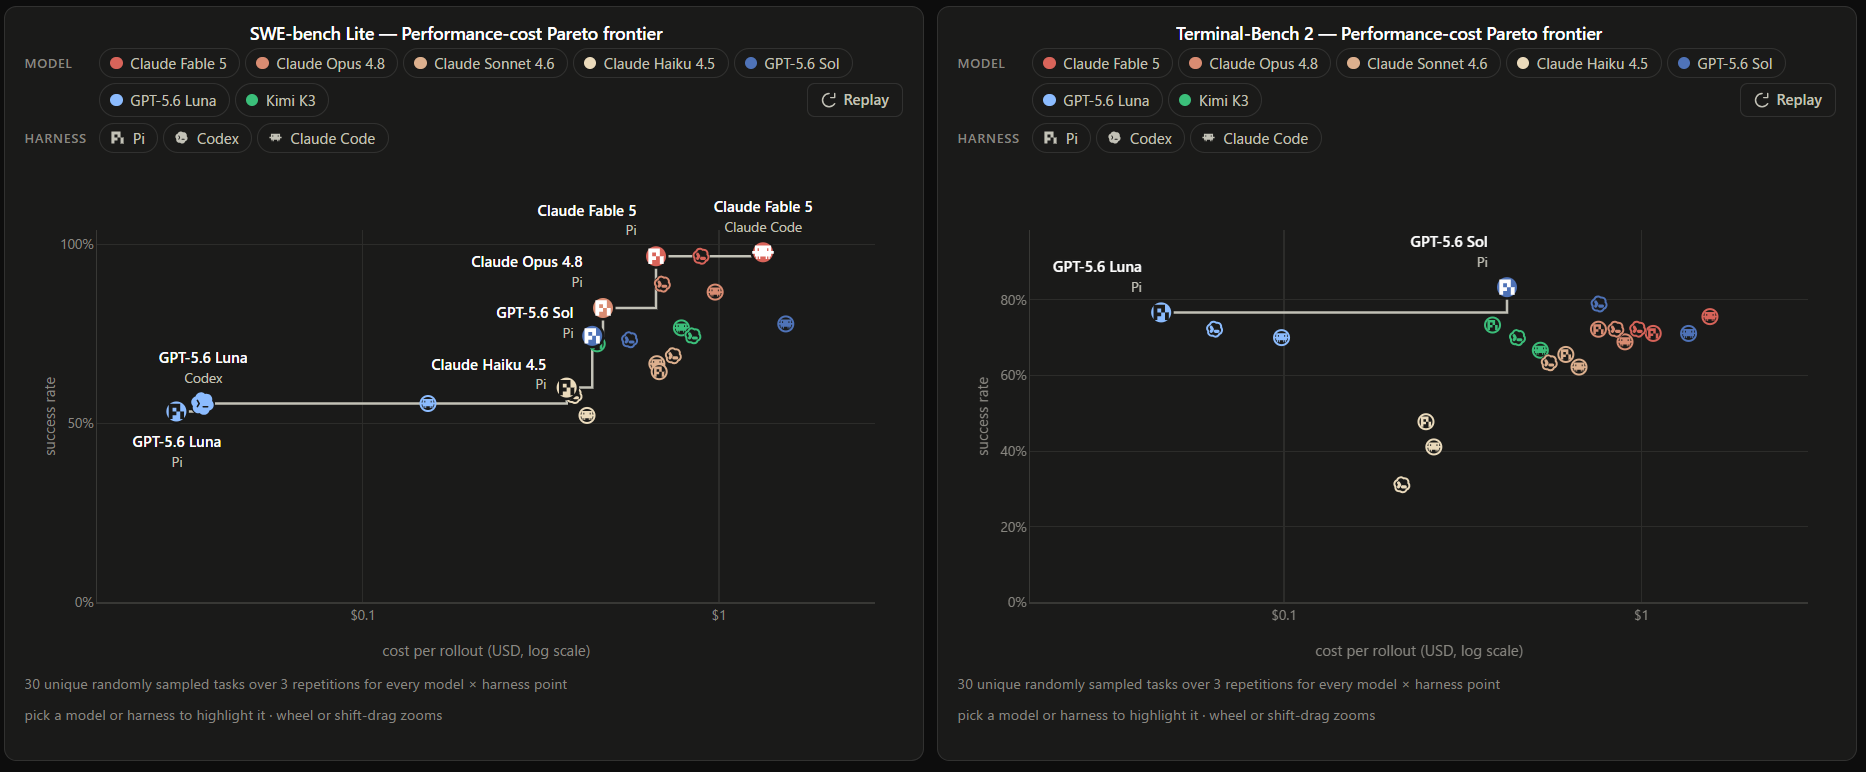
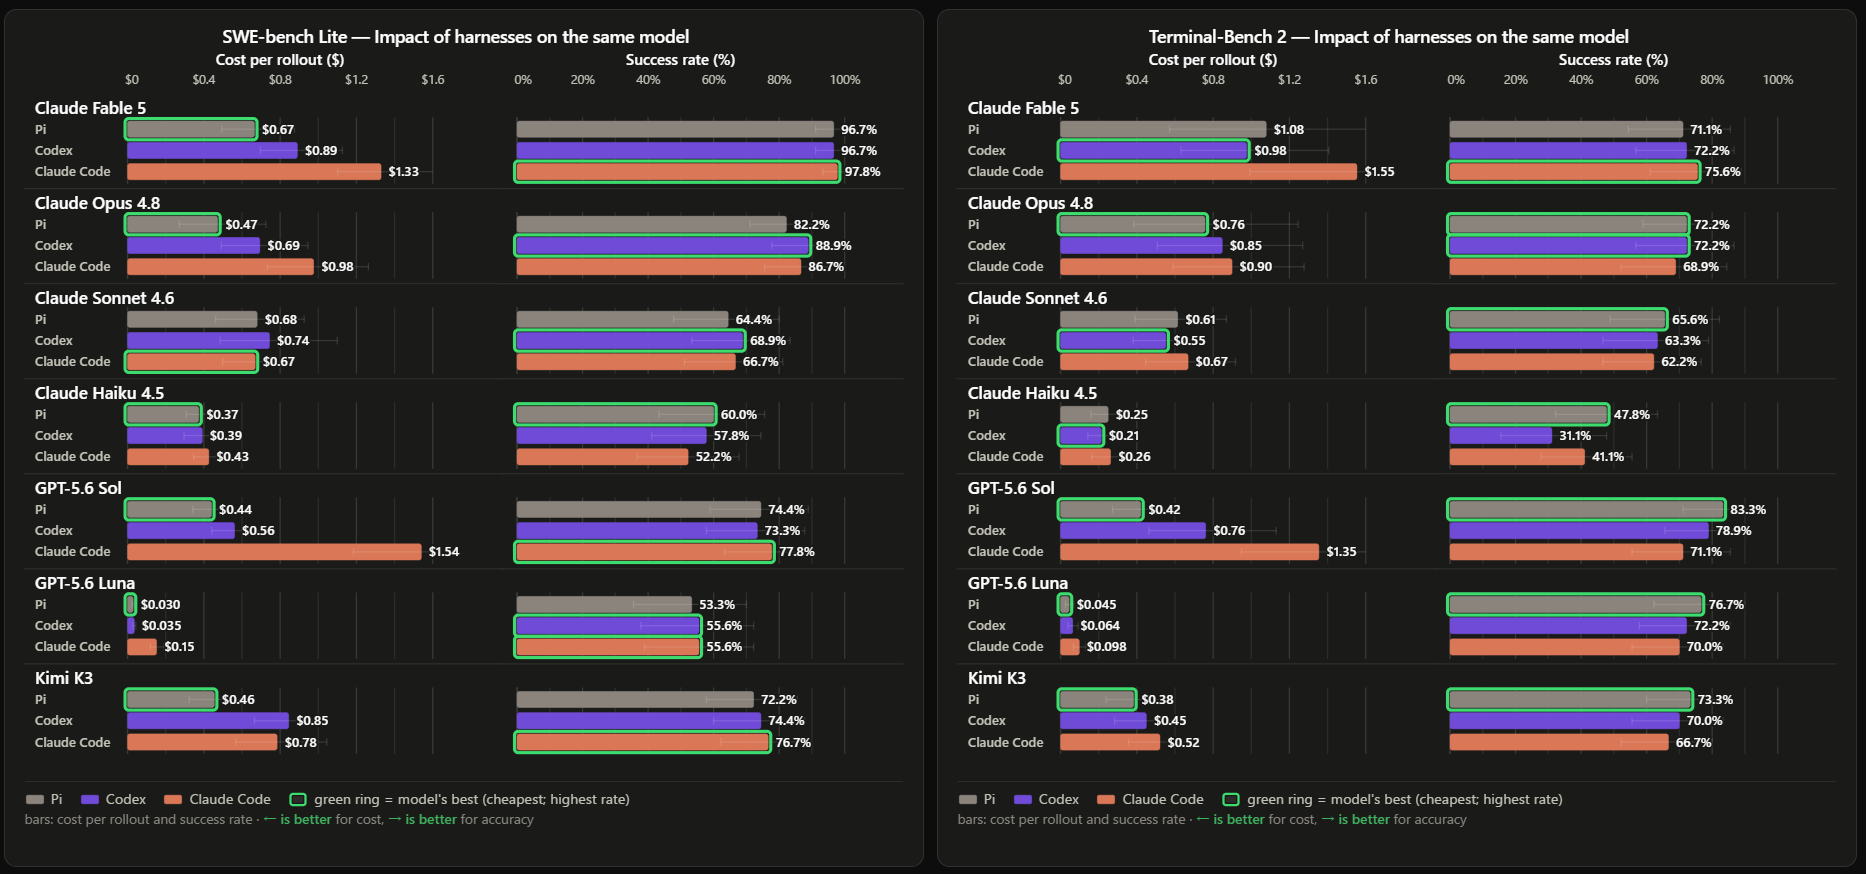
研究で最初に示されたのは、ハーネスの違いがタスクの正解率よりも費用に大きく影響するという結果です。同じモデルを使っている限り、ハーネスを変えても成功率は大きく変化しない一方、必要なコストには明確な差が生じました。たとえばClaude Fable 5は、Claude Codeで試行の97.8%を解決し、CodexとPiでは96.7%を解決しました。Claude Codeの成功率はわずかに高かったものの、費用はPiの約2倍でした。SWE-bench Liteでは、共通して利用できるモデルを比較すると、Claude Codeの費用は幾何平均でPiの約2倍、Codexの約1.6倍でした。Terminal-Bench 2.0でも、Claude CodeはPiより約1.5倍高くなっています。
一方、ハーネスを変えたことによる成功率の平均的な差は、SWE-bench Liteではプラスマイナス2%以内、Terminal-Bench 2.0でもおおむねプラスマイナス5%以内に収まりました。研究チームは、ほぼ同じ品質の結果を得るために余分な費用を支払う状態を「ハーネス税(Harness Tax)」と表現しています。エージェントの初期設定をそのまま使うだけでは、この費用差を見落とす可能性があります。
また、ターン数が同程度でも1ターン当たりに処理するトークン量などが異なれば、支払う費用は変わります。たとえば、Claude Fable 5をSWE-bench Liteで動かした場合、Piの平均ターン数は15.4、Claude Codeは15.3でほぼ同じでした。それにもかかわらず、Claude Codeの費用は約2倍で、成功率の上昇は1.1ポイントにとどまりました。
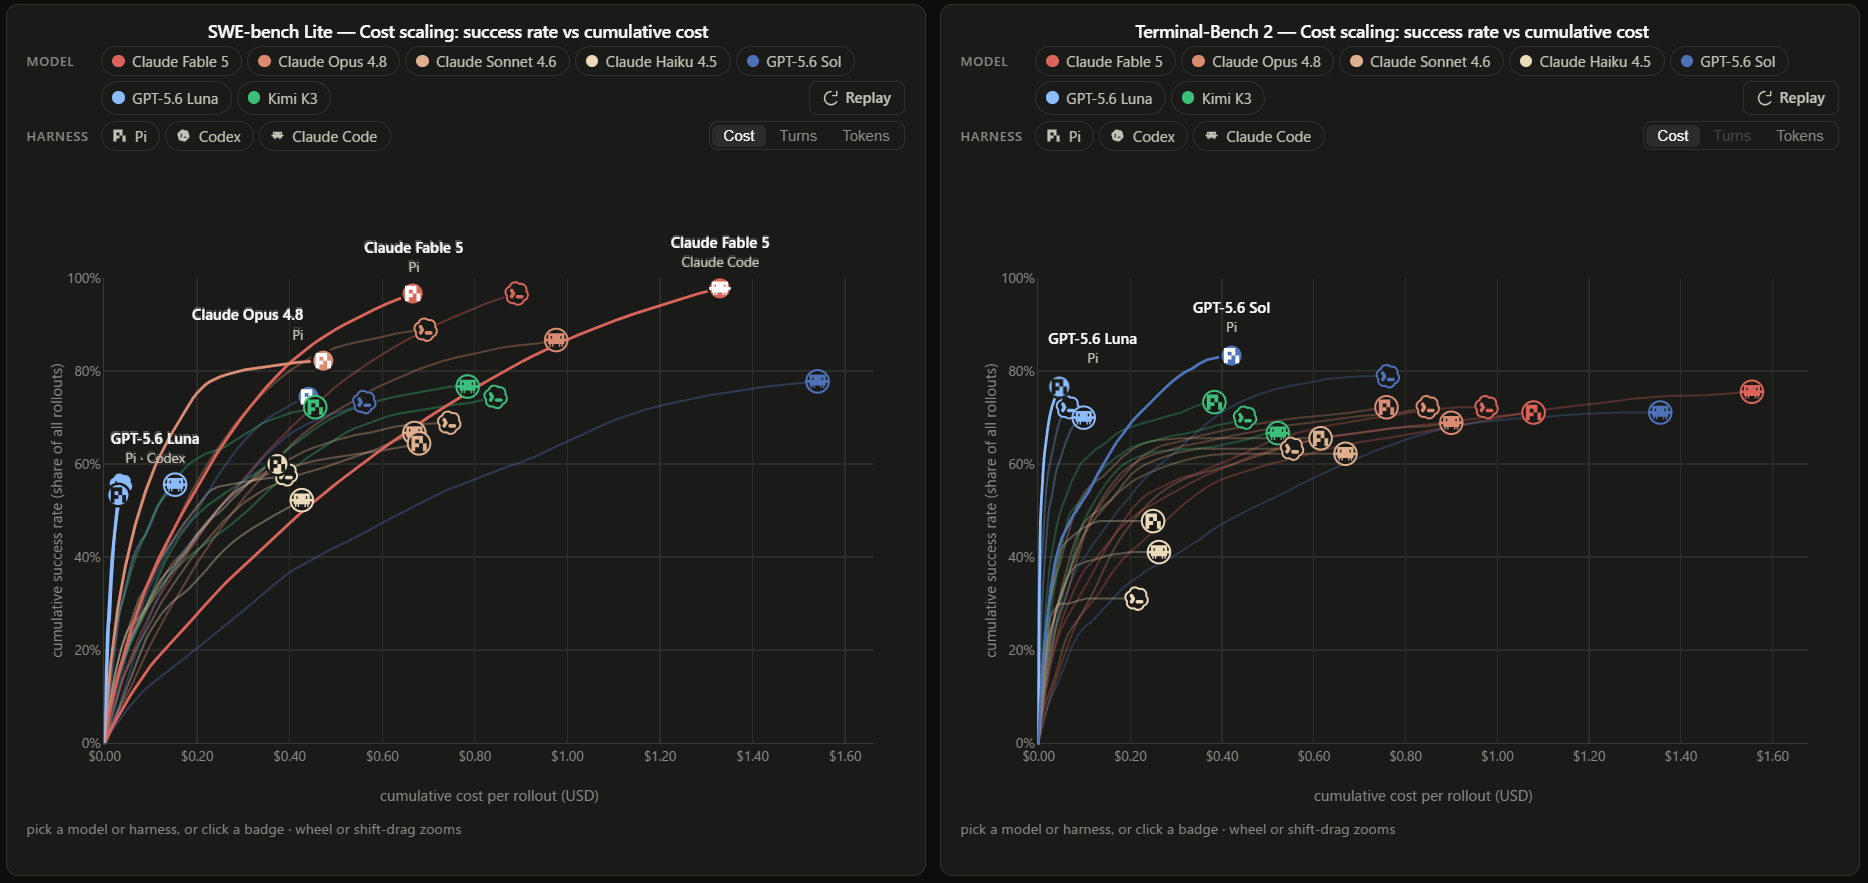
完了した試行を安い順に並べ、累積費用と成功率の関係を示したグラフがこんな感じ。失敗した試行も費用として加算されるため、同じ成功率を目指す場合でも、どのハーネスが早い段階で成功を積み上げられるかによって、必要な総費用が変わります。費用差の一因は、モデルに最初に渡されるコンテキストにもあります。コンテキストとは、タスクの説明やハーネスの指示、利用可能なツールの仕様など、モデルが最初の判断を行うために読む情報です。
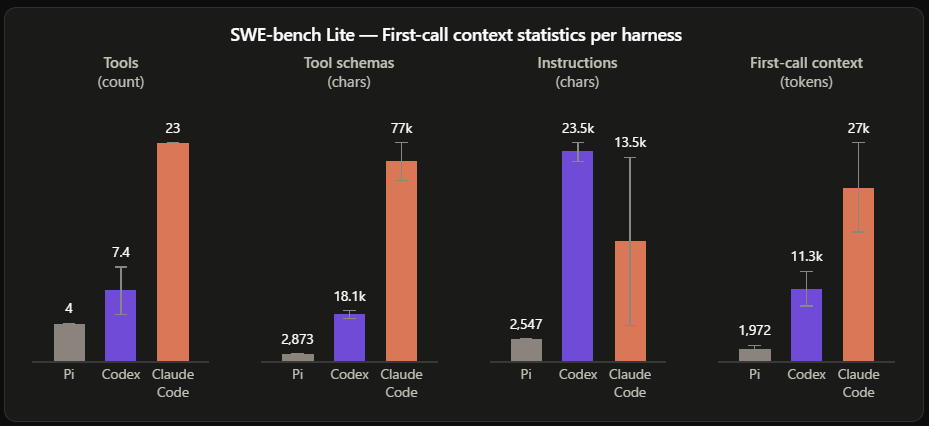
以下のグラフは、SWE-bench Liteでモデルが最初に受け取る情報量をPi・Codex・Claude Codeで比較したものです。左から「利用可能なツール数」「ツール仕様の文字数」「指示文の文字数」「最初のモデル呼び出しに含まれる入力トークン数」を示しています。7つのモデル全体で見ると、Claude Codeの初期コンテキストはPiの10倍を超えていました。Claude CodeではPiに比べて指示文が長く、ツールの仕様も平均約7万7000文字と大きくなっています。初期コンテキストが大きければ、その分だけ入力トークンの処理費用が増える可能性がありますが、最終的な総費用はキャッシュの利用状況やモデルが生成するトークン、後続の呼び出し回数などにも左右されます。そのため、コンテキスト量だけで費用差のすべてを説明できるわけではありません。
研究では、機能が豊富なハーネスほど有利になるとは限らないことも示されています。オープンソースのPiは、read、write、edit、bashという4つのツールだけを提供するシンプルな構成ですが、SWE-bench LiteとTerminal-Bench 2.0の両方でパレートフロンティアに入りました。研究チームは、豊富な機能を備えることが成功率の向上に直結するわけではないと指摘しています。
実際の費用はツールの数だけでなく、指示文やツール定義の長さ、モデルが行う呼び出しの回数、生成されるトークン数などの組み合わせで決まります。PiやCodexが既存モデルを使いながらClaude Codeと同程度の成功率をより低い費用で達成できたことは、オープンソースのハーネス研究に余地があることを示しています。研究者は、プロプライエタリなハーネスへのアクセスやモデルとの共同学習がなくても、最先端のコーディングハーネスに取り組めるというわけです。
ただし、シンプルなハーネスが常に最適だと決まったわけではありません。今回の結果は2つのオープンソースベンチマークに限られており、モデルがこれらのベンチマークを学習時に見ていた可能性もあります。別のベンチマークや実際の開発作業では、より多くの機能を持つハーネスが有利になる可能性もあります。ハーネスの複雑さは、機能の多さで判断するのではなく、用途ごとに費用と性能を測定して評価する必要があります。
さらに、モデルの提供元が用意したハーネスを使えば最も高い性能が得られるとは限らないことがわかりました。AnthropicのモデルとClaude Code、OpenAIのモデルとCodex CLIのように、提供元が自社の開発環境向けにモデルを最適化している場合でも、その組み合わせが優位であるとはいえませんでした。AnthropicとOpenAIの6モデルを2つのベンチマークで比較した12通りの比較では、最高の成功率を記録したハーネスが、モデル提供元とは異なるケースが9通りあったとのこと。
SWE-bench LiteとTerminal-Bench 2.0について、各モデルをPi、Codex CLI、Claude Codeで動かしたときの1回当たりの平均トークンコストと成功率を比較したものが以下です。緑色の枠は、モデルごとに最も低い費用と最も高い成功率をそれぞれ示しています。SWE-bench LiteでClaude Sonnet 4.6を使った場合、Codexでの成功率は68.9%で、Claude Codeの66.7%を上回りました。両者の費用は近い水準でした。また、Terminal-Bench 2.0でGPT-5.6 Solを使った場合、Piの成功率は83.3%で、Codexの78.9%を上回りました。Piの費用はCodexの約半分でした。
研究チームは、今回の調査結果は「モデルの能力が特定のハーネスに完全に閉じているわけではなく、別のハーネスにも移せることを示している」とコメント。重要なのは「モデルの提供元がどこか」ではなく「実際の作業でどのハーネスが費用と成功率のバランスを最もよく保てるか」だとしています。
・関連記事
AIエージェントの「ハーネス」とは?AIモデルを実際に働かせる4つの仕組み - GIGAZINE
GPT-6 AstraとClaude Fableの性能を引き出すハーネス「Fusion」が登場、Claude CodeやCodexで使う場合と同等の性能を示しつつコストを最大39%削減 - GIGAZINE
Codexと同じハーネスを使ってAIエージェントを作れる「Agents API」が登場 - GIGAZINE
コスト削減のためにAIエージェントの出力を短くすると逆にコストがかさむ事例をGitHubが公開、うまくコスト効率を向上するにはどうすればいいのか - GIGAZINE
・関連コンテンツ
in AI, ソフトウェア, Posted by log1i_yk
You can read the machine translated English article How important is a harness for an AI cod….