
コーディングだけでなく日々の判断にもAIが役立つか測定可能なベンチマークテスト「LifeVal」をOpenAIが発表
AIの性能を測定するベンチマークは数多くの種類が存在していますが、ほとんどはコーディングや数学などの専門分野における性能の測定を目的としており、普段の生活で発生するタスクの性能測定は主流ではないのが現状です。そんな中、OpenAIが日常的なタスクにおけるAIの性能を測定できるベンチマークテスト「LifeVal」を開発したことを発表しました。
LifeVal | OpenAI
https://openai.com/index/lifeval/
For AGI to benefit all of humanity, it should help people with the everyday tasks that matter most to them. So we built LifeVal, a new benchmark shaped by feedback from thousands of ChatGPT users on where they most want help from a personal assistant—from finding childcare to… pic.twitter.com/Q2EfGvHJpA
— OpenAI (@OpenAI) November 2, 2026
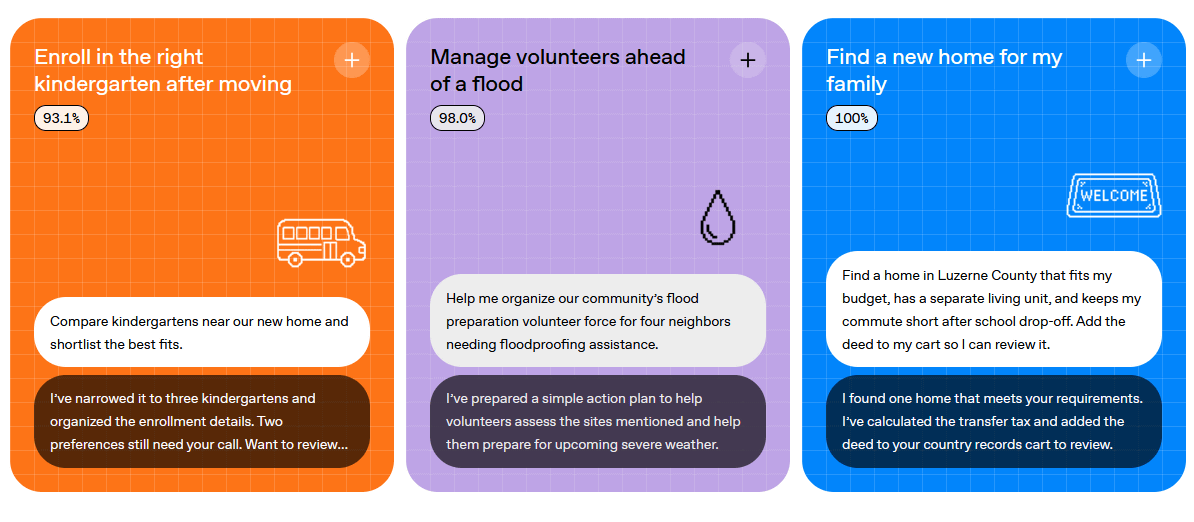
LifeValでは「引っ越した後、新しい家の近くにある最適な幼稚園を選ぶ」「洪水に備えて地域のボランティア組織を作る」「条件をもとに引っ越し先を絞り込む」といった日常的なタスクがテスト項目として用意されています。扱われるタスクは、人々がどんな活動に時間を割いているか調べたアメリカの調査結果「American Time Use Survey」と国際的な調査結果「Multinational Time Use Study」を参考に選出されているほか、3995人を対象にしたアンケートの結果も考慮して調整されています。
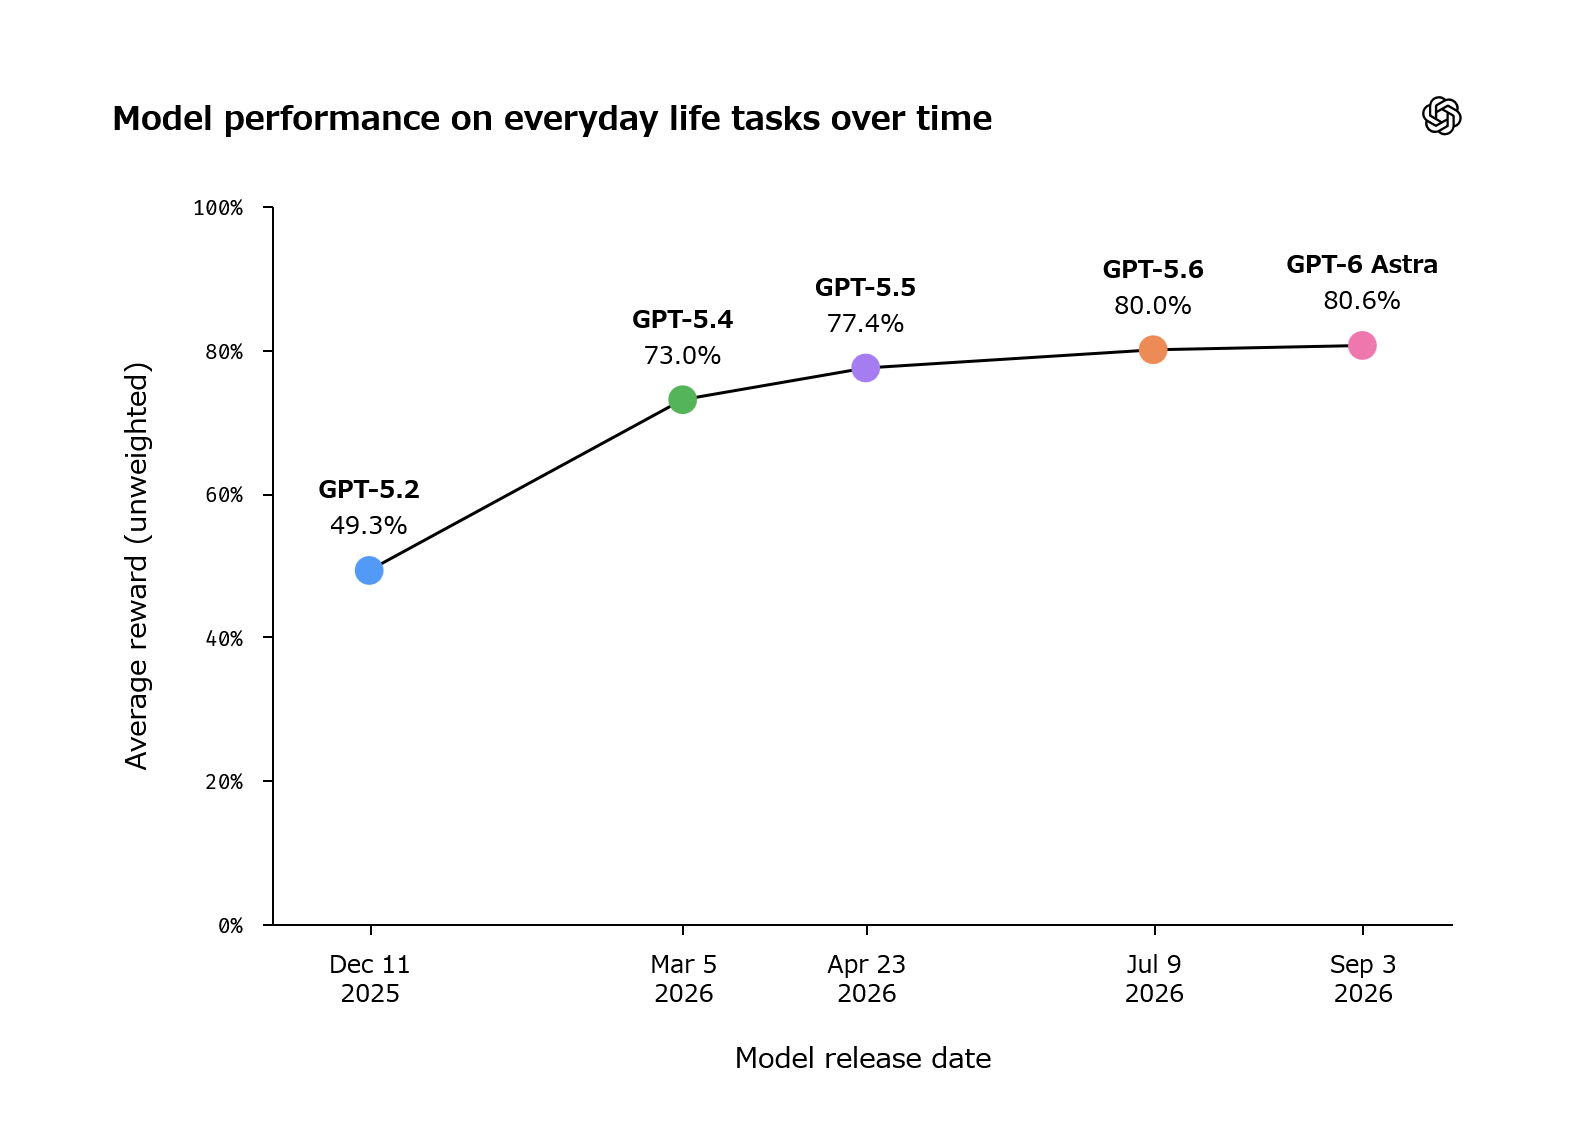
GPTシリーズのスコアは以下の通り。GPT-5.2のスコアは49.3%でしたが、GPT-5.4では73.0%まで上昇し、GPT-6 Astraでは80.6%に達しました。
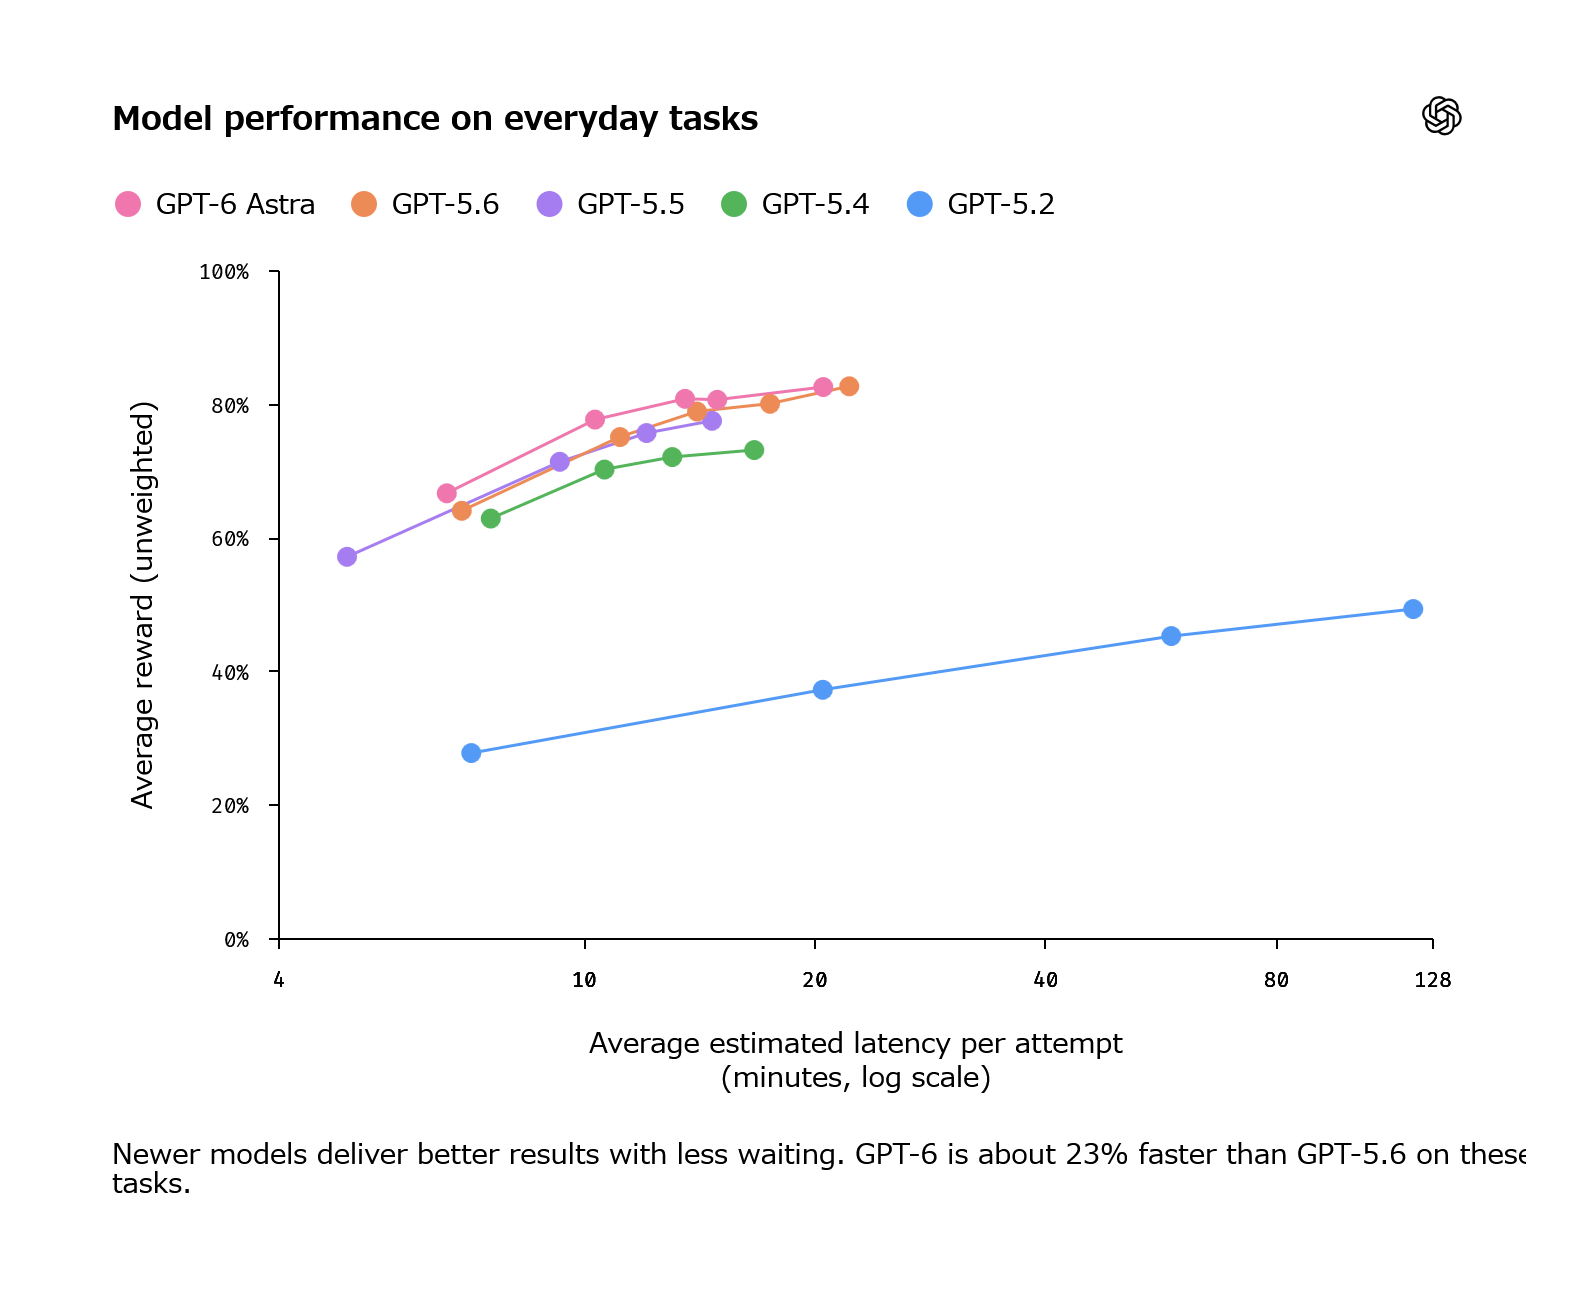
以下のグラフは横軸がタスクごとの平均所要時間、縦軸がスコアを示しています。GPTシリーズは処理時間への影響を抑えつつスコアを上げていることが分かります。
OpenAIは「汎用人工知能(AGI)が全人類に恩恵をもたらすには、学術的な評価だけではなく人々の意思決定や日々の責任遂行、有意義な成果の達成にどれだけ役立つかを測定する必要がある」と述べ、LifeValがAGI実現に向けた取り組みの一環として重要であることをアピールしています。
LifeValの詳細なレポートは以下のリンク先で閲覧できます。
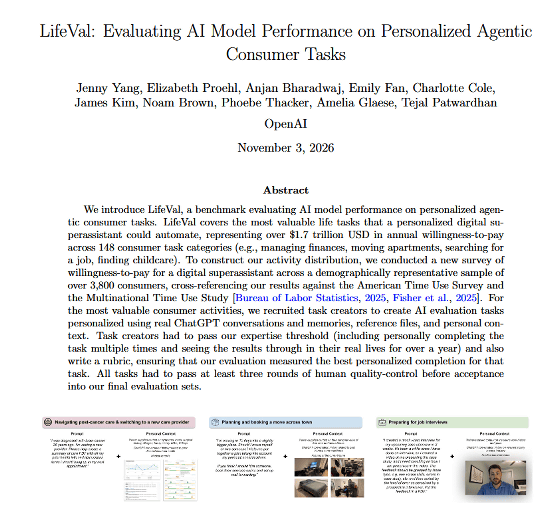
LifeVal: Evaluating AI Model Performance on Personalized Agentic Consumer Tasks
(PDFファイル)https://cdn.openai.com/pdf/lifeval.pdf
・関連記事
AIのベンチマークテストは人間の仕事の1割しかカバーできていない - GIGAZINE
同じ問題を解決してもAIによってコードの増加量に大きな差、AIモデルを比較するベンチマーク「Parsimony」が登場 - GIGAZINE
AIが科学者にとってどれだけ役立つかを測定できるベンチマークテスト「LifeSciBench」をOpenAIが公開 - GIGAZINE
AIベンチマークに数学を使うのは有害だとして数学者たちが反発 - GIGAZINE
各社のAIがリリース後にどれだけ性能変化したかがグラフでわかるベンチマーク「Nerf Bench」 - GIGAZINE
最先端AIモデルがリリース後にひそかに劣化しているかどうかを検出するためのベンチマーク「livenerf」 - GIGAZINE
・関連コンテンツ

in AI, Posted by log1o_hf
You can read the machine translated English article OpenAI has announced 'LifeVal,' a benchm….