
長期反復タスクにおけるAIコーディングエージェントの性能低下をベンチマークする「SlopCodeBench」
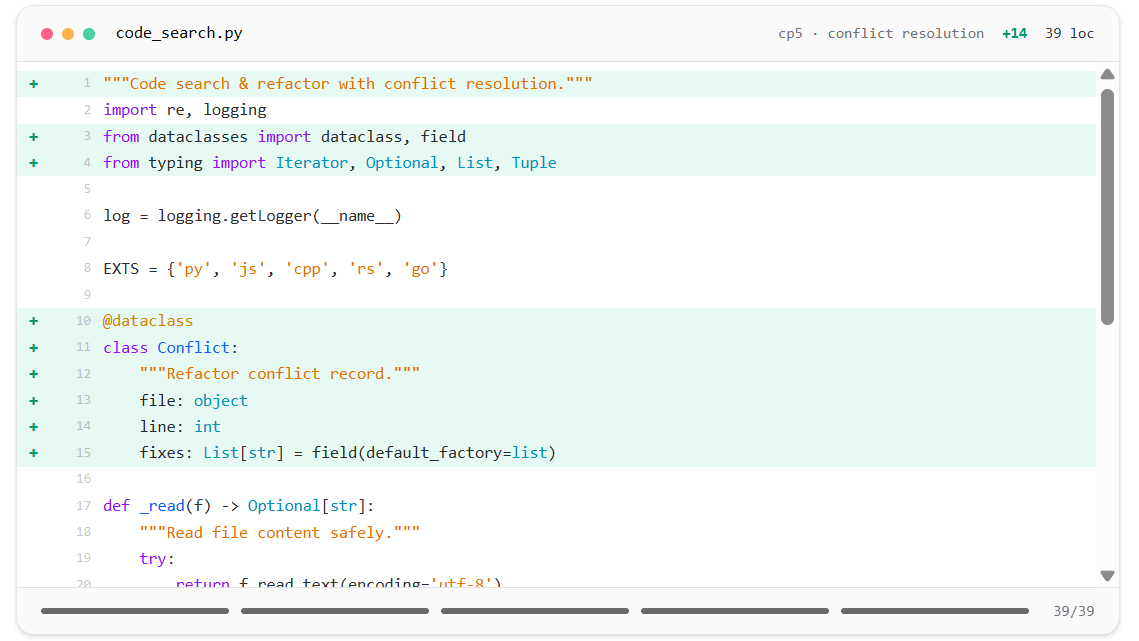
AIにプログラムを作成させると短時間で動作するコードを得られますが、機能の追加を繰り返すうちに古い処理との整合性が崩れたりコードが複雑になったりすることがあります。こうした問題を調べるために開発され、AI自身が作ったコードに新しい仕様を段階的に追加させながら機能の維持や品質の変化を測定するベンチマークが「SlopCodeBench」です。
SlopCodeBench
https://www.scbench.ai/
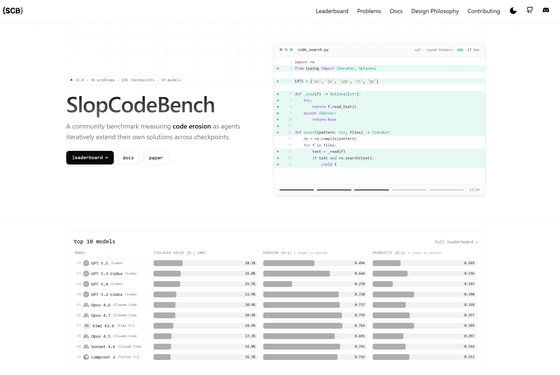
SprocketLab/slop-code-bench: SlopCodeBench: Measuring Code Erosion Under Iterative Specification Refinement
https://github.com/SprocketLab/slop-code-bench
advanced-context-engineering-for-coding-agents/benchmarking-new-models-on-slop-code-bench.md at main · humanlayer/advanced-context-engineering-for-coding-agents
https://github.com/humanlayer/advanced-context-engineering-for-coding-agents/blob/main/benchmarking-new-models-on-slop-code-bench.md
◆SlopCodeBenchとは
SlopCodeBenchはAIが作ったプログラムに新しい仕様を段階的に追加し、繰り返し修正する間の動作やコード品質を測定します。
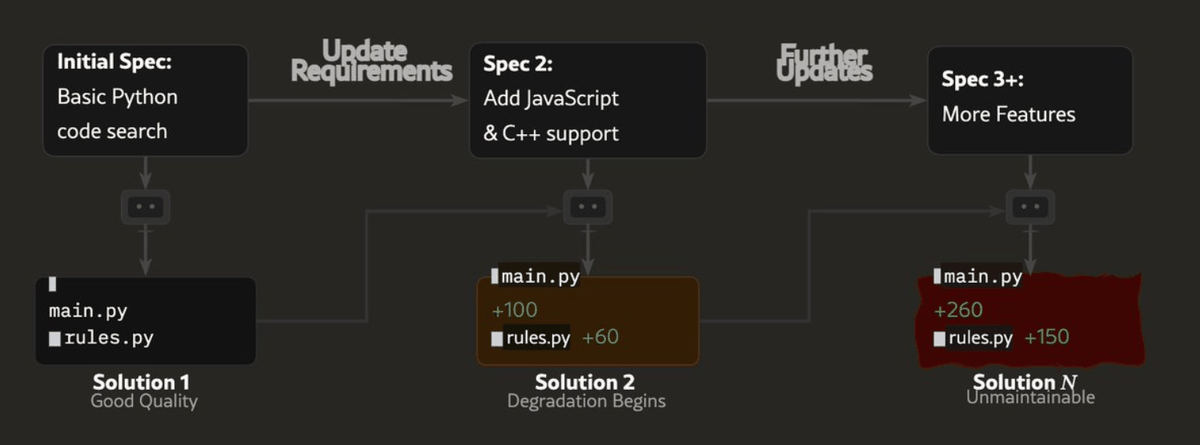
◆SlopCodeBenchの仕組み
・仕様変更を繰り返すチェックポイント
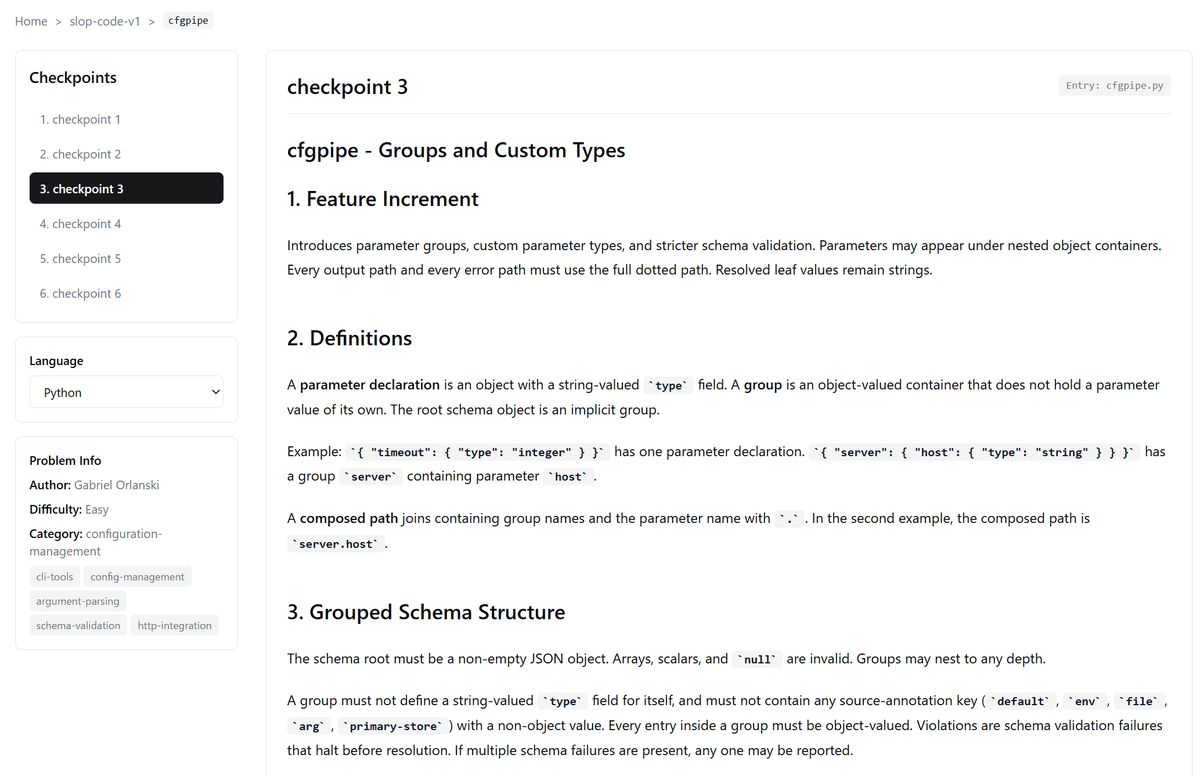
公式サイトの「Problems」では設定ファイルの処理やデジタル回路の評価など36種類の課題を閲覧でき、課題ごとに複数のチェックポイントを用意。
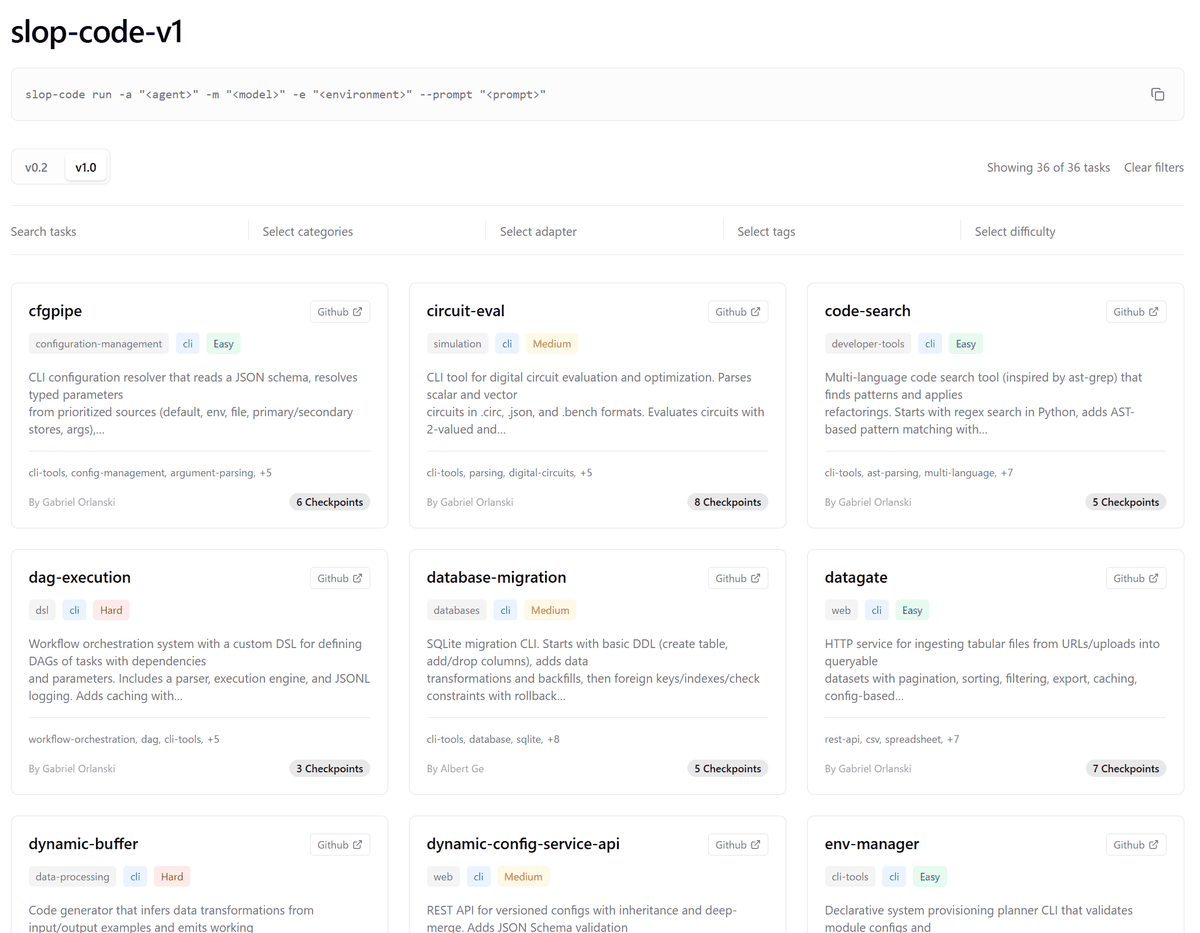
例えば「cfgpipe」という課題には6つのチェックポイントがあり、最初は設定ファイルを解析して結果を出力するプログラムの仕様が提示されます。
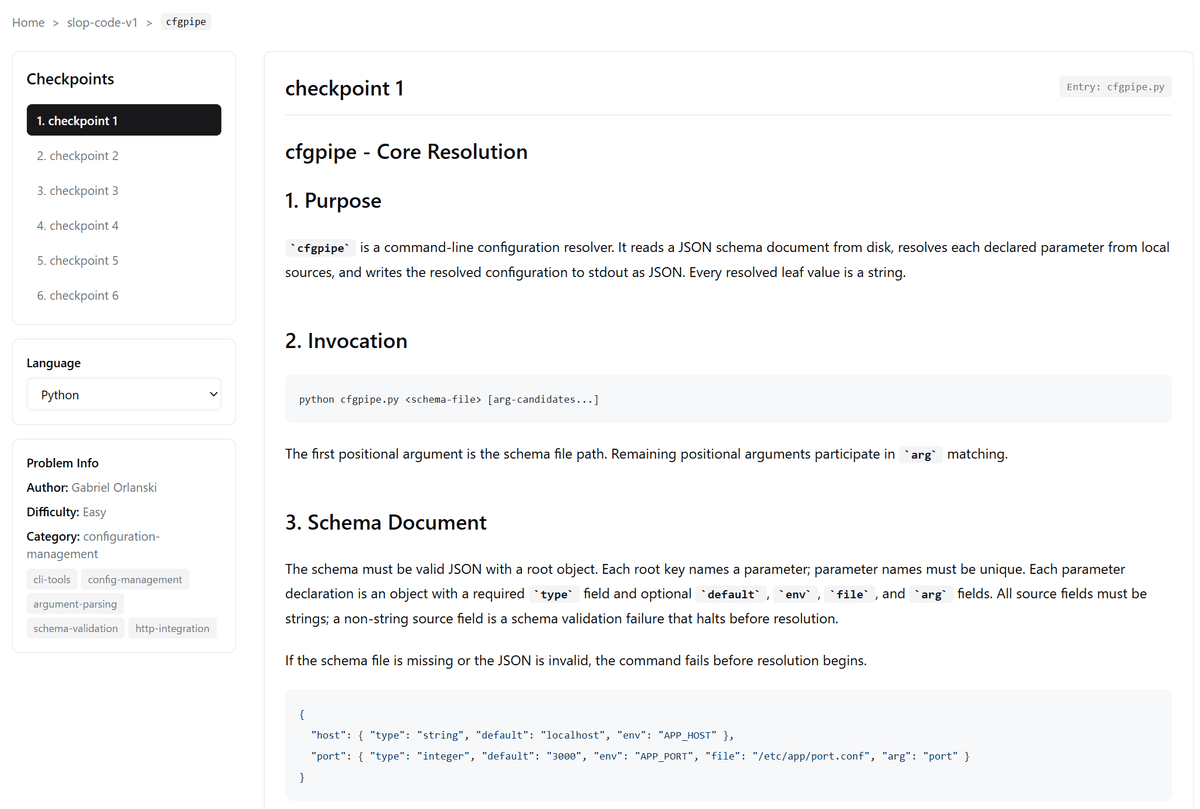
AIは新しい要求が届くたびに前のコードを引き継いで機能を拡張するため、初期に選んだプログラムの設計が後の修正にも影響します。
◆AIコーディングエージェントの検証結果
・新しい機能には対応できても過去の機能を維持するのは難しい
各段階の新しい機能を検証する「Core」と、過去の機能も含む全テストに合格したかを判定する「Strict」を分けて評価するとCore合格率は65.82~73.98%だったのに対し、Strict合格率は12.24~16.33%で、過去の機能を維持しながら開発を続ける難しさが表れています。
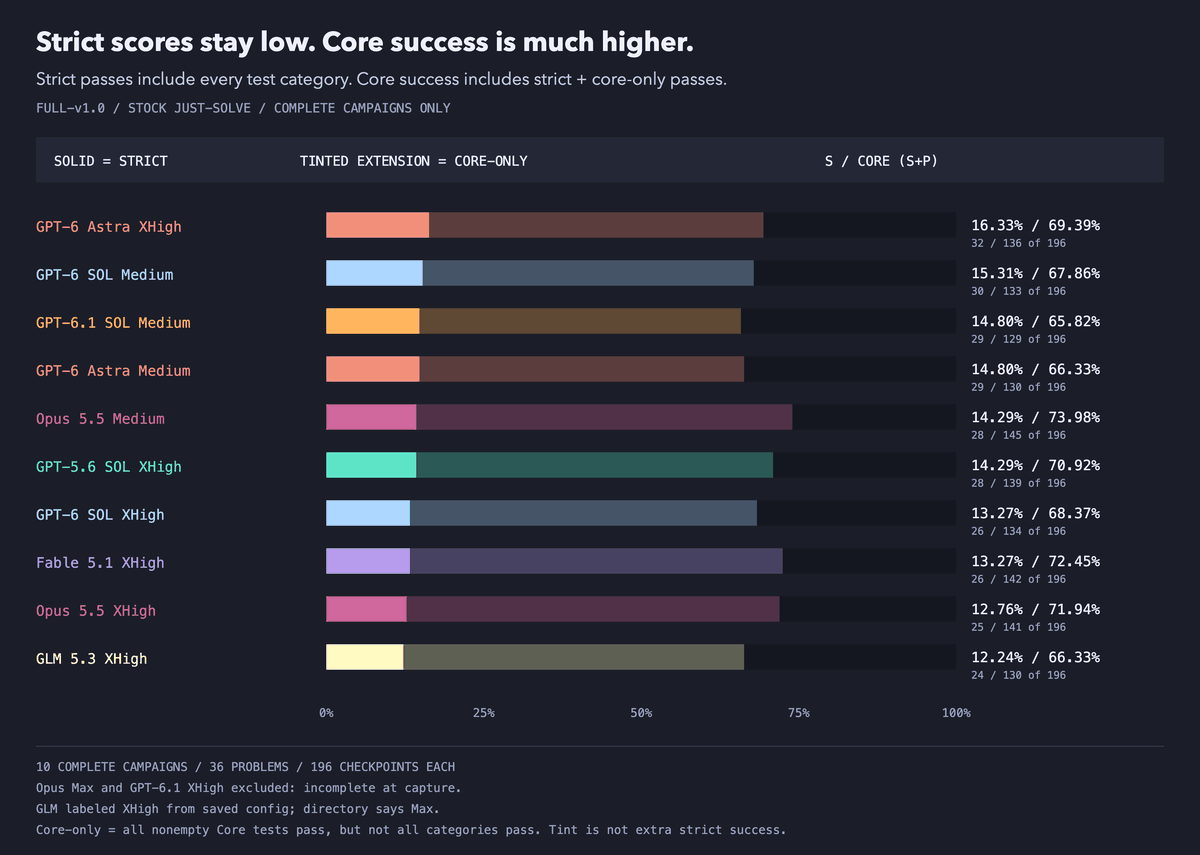
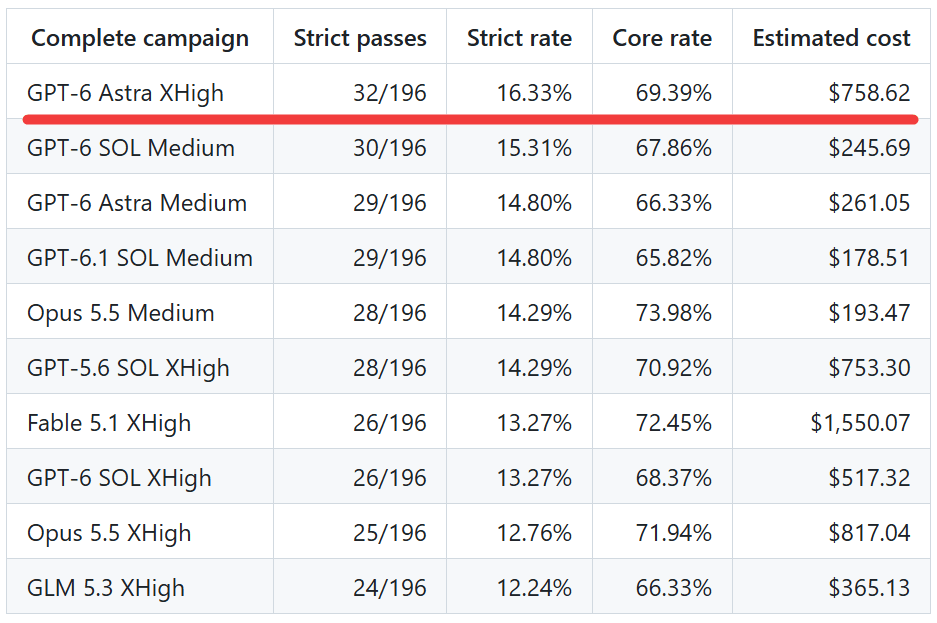
Strictで最高だった「GPT-6 Astra XHigh」は196あるチェックポイントのうち32件に合格して16.33%を記録し、次点の「GPT-6 SOL Medium」は30件で15.31%でした。
・推論量を増やしても合格率が向上するとは限らない
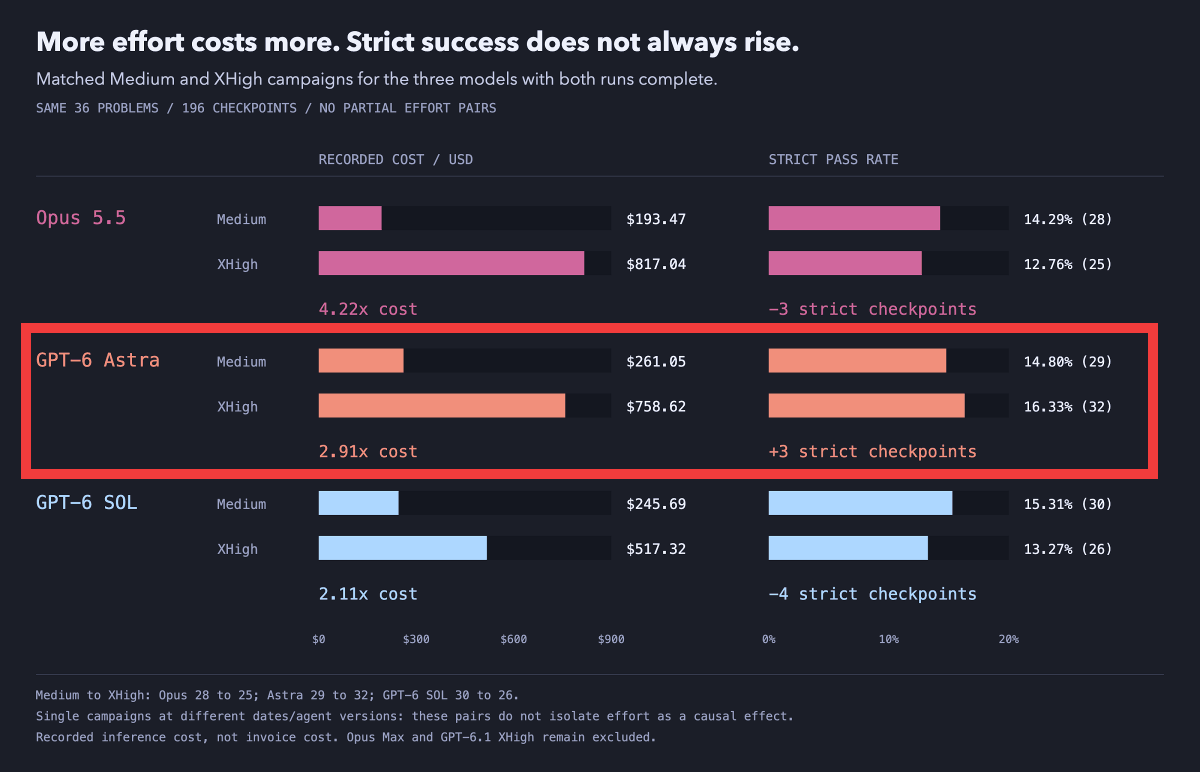
「Opus 5.5」は推論量がMediumのとき28件に合格した一方、XHighでは25件に減少し、推定実行コストは193.47ドル(約3万900円)から817.04ドル(約13万500円)へ約4.22倍に増加しました。
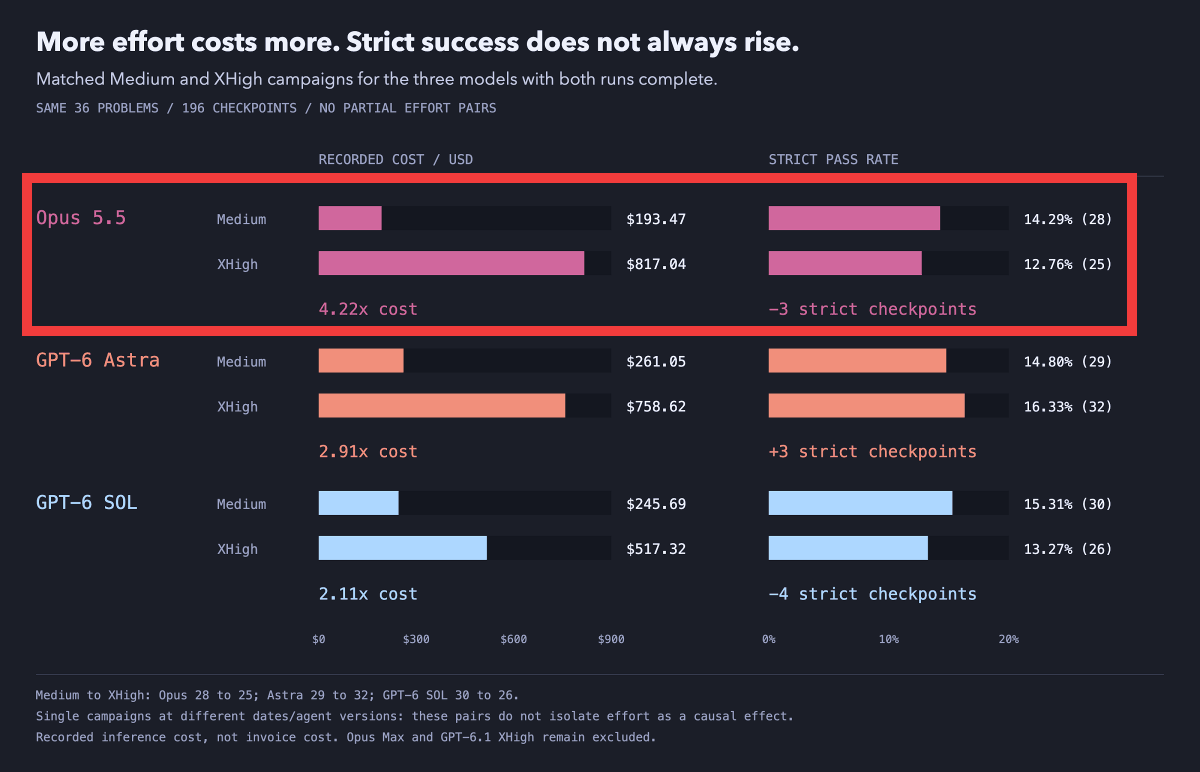
ただしAstraではXHighのほうが好成績で各条件の実行回数も1回のため、推論量の増加が性能低下の原因とは断定できません。
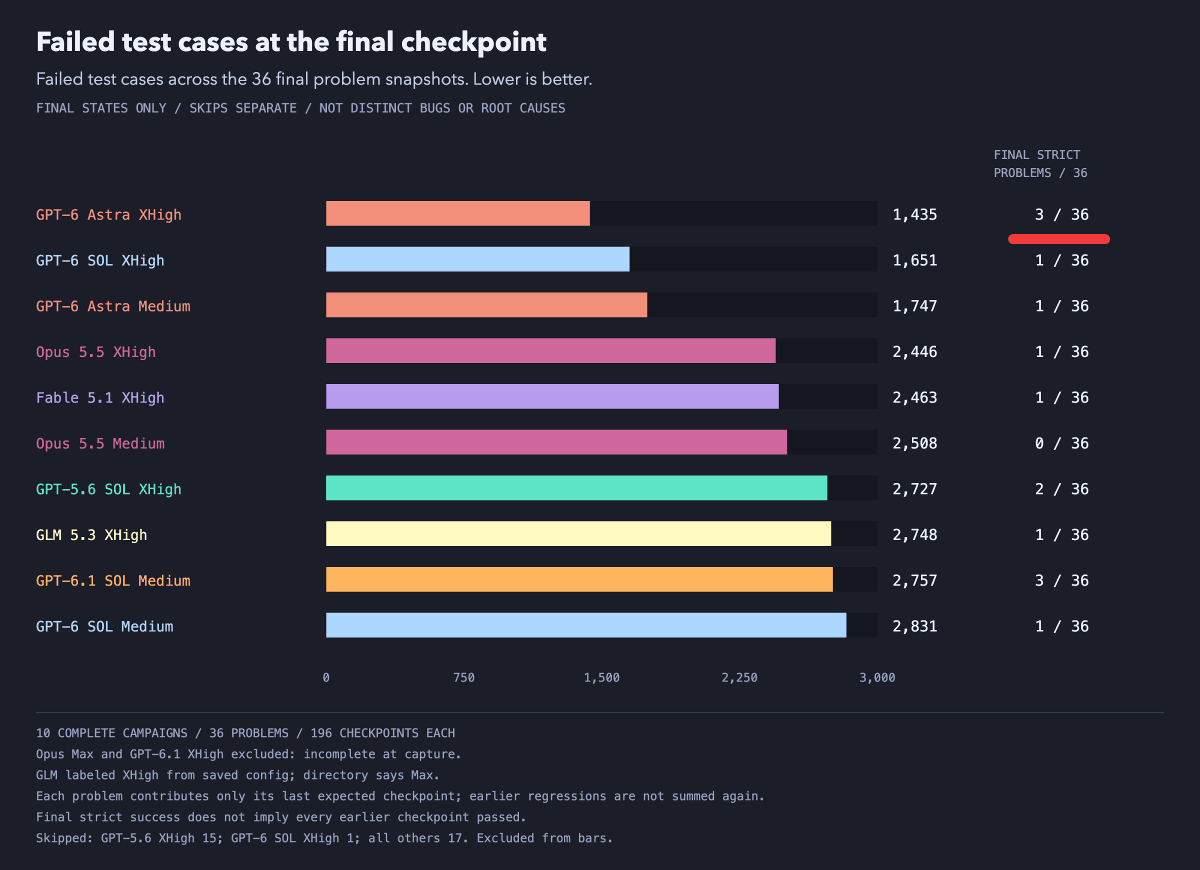
・最終的に完成したプログラムの合格率
36課題の最終段階に絞ると全テストに合格した課題は最多でも3件で、途中で成果を出したAIでも完成まで機能を維持することは難しいという結果になりました。
◆生成されたコードの品質
SlopCodeBenchは機能の成否だけでなく、複雑な関数が増える「構造的な劣化」や重複した処理が増える「冗長性」も調べます。10月の検証では共通する28課題の最終コードを調査し、Opus 5.5の問題パターンが検出された行の割合はXHighで77.75%、Mediumで94.25%でした。
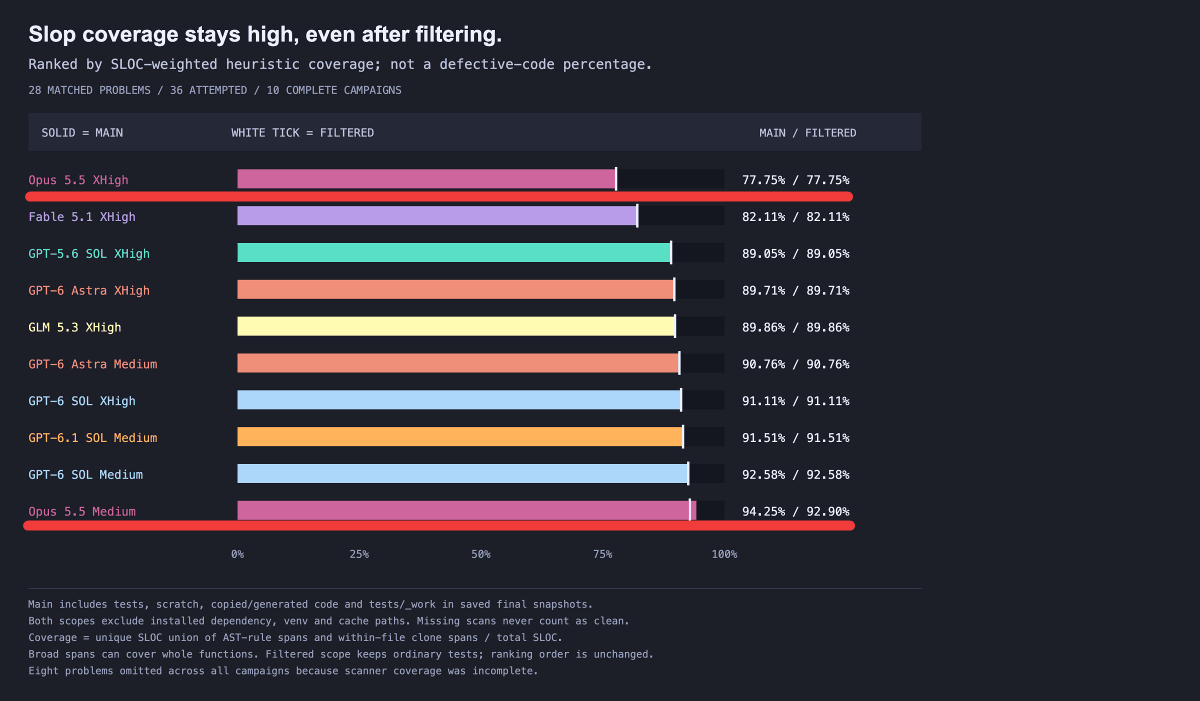
これは実際のバグの割合ではなく検出ルールに該当したコード行の割合で、テスト合格率が高い設定ほどコードが簡潔になるとは限らないことを示しています。
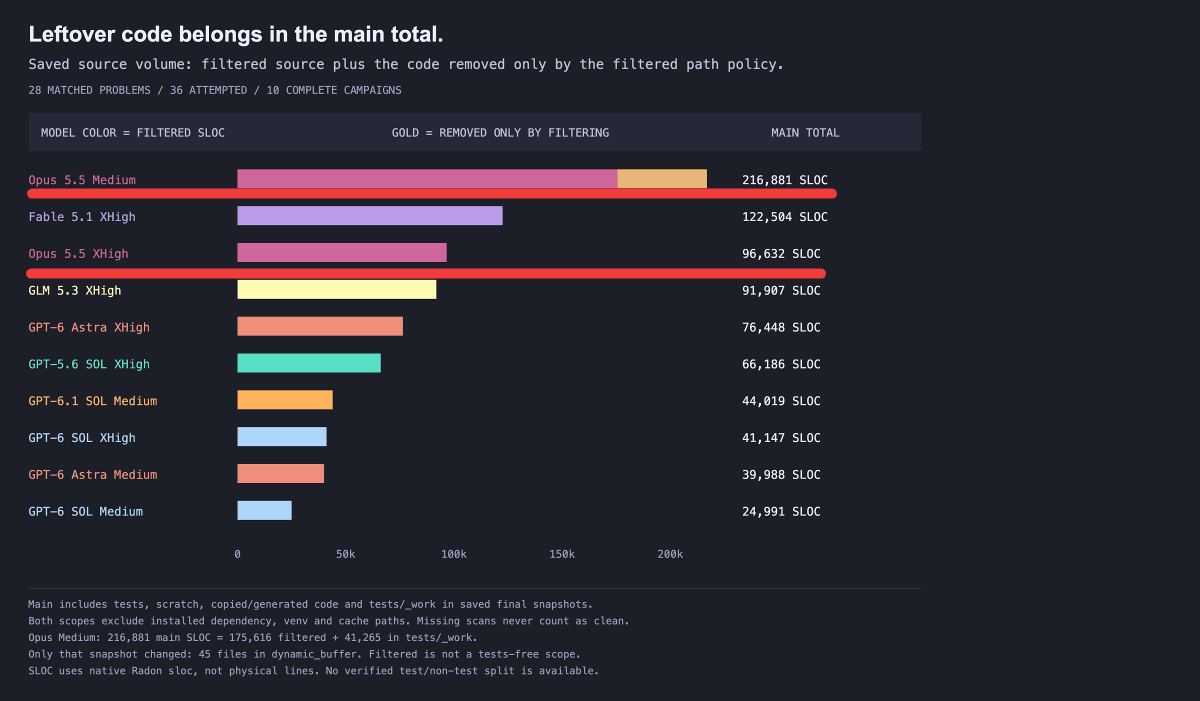
SlopCodeBenchの結果は、AIが新しい機能を作れることと、変更を重ねても既存機能やコード品質を維持できることが別の能力であると示しています。
◆公式サイトで結果を確認する
公式サイトの「Leaderboard」ではモデルごとの合格率やコード品質の指標を確認できます。
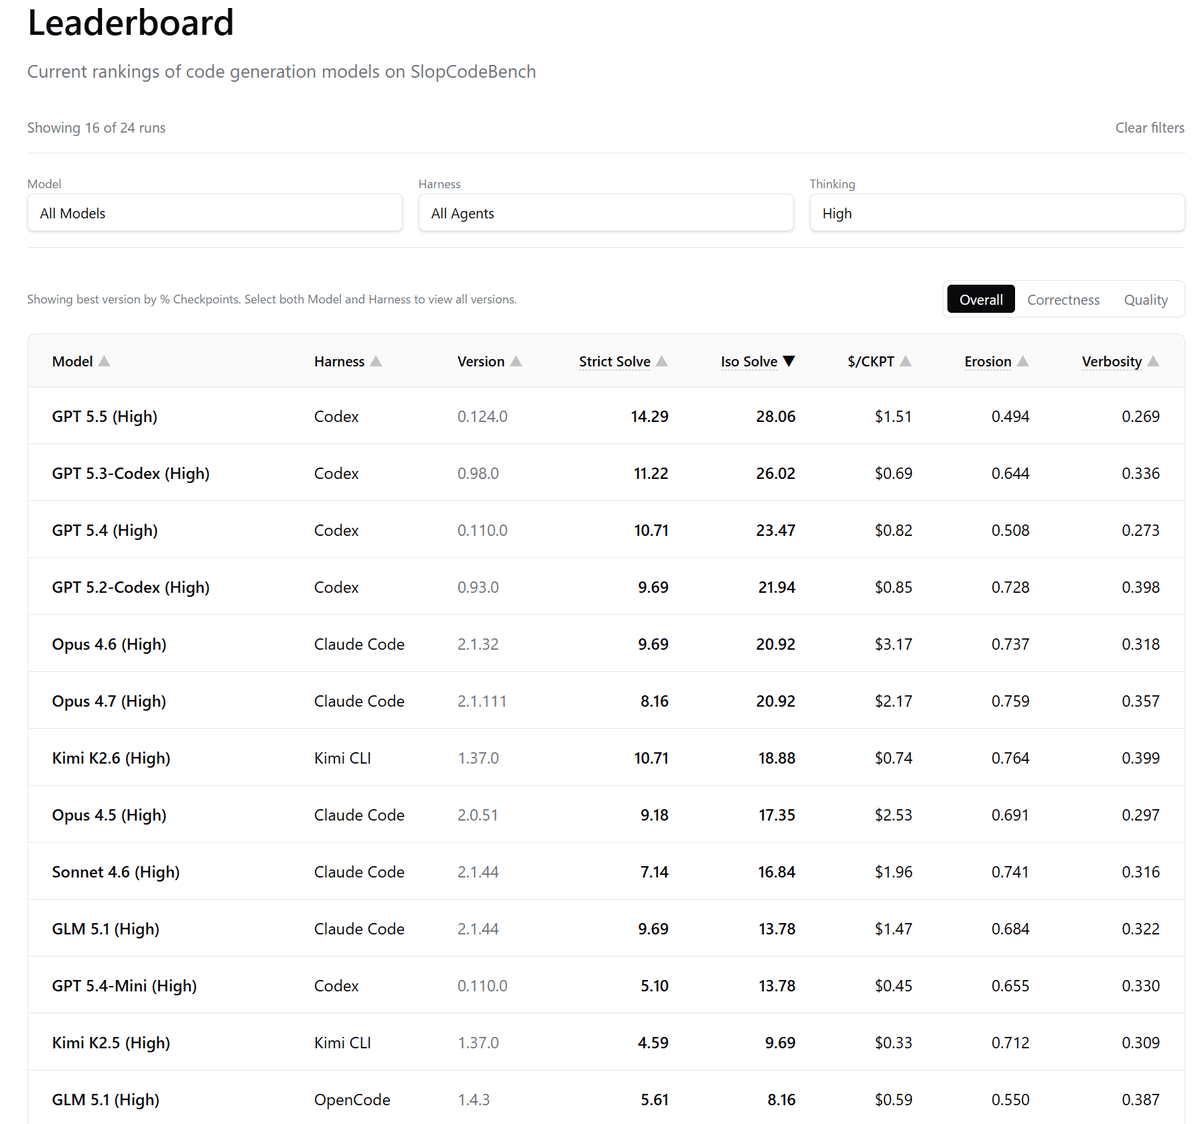
ベンチーマークのソフトウェア本体はGithubの公式リポジトリから無料で取得でき実行できますが、検査項目も多くクレジットも大量に消費するためコスト管理に注意が必要です。
◆SlopCodeBenchの評価
ソーシャル系ニュースサイトのHacker NewsではSlopCodeBenchについて議論が行われており「LLMによる過剰に防御的なプログラミングが複雑なコードを生む」という意見がある一方、「優れたベンチマークであり低い推論設定が賢明な選択になる場合もある」という評価も投稿されています。これに対して検証記事の執筆者Dex Horthy氏は「6課題だけで試した際のFableの合格率は33%だったのに対して全課題では14~15%程度だった」と説明しています。
◆まとめ
SlopCodeBenchを利用するとモデルの合格率に加えて実行コストやコードの劣化も確認できるため、長期的な開発をAIに任せる際の評価方法として活用できます。
・関連記事
AIのベンチマークテストは人間の仕事の1割しかカバーできていない - GIGAZINE
AIベンチマーク「Intelligence Index v5」発表、2つの新しいベンチマークと3つのアップグレード - GIGAZINE
AIエージェントが試験で一生懸命「カンニング」していることが発覚 - GIGAZINE
「Balatro」をどのAIが最も上手くプレイできるのかが分かるベンチマーク「BalatroBench」 - GIGAZINE
コーディングだけでなく日々の判断にもAIが役立つか測定可能なベンチマークテスト「LifeVal」をOpenAIが発表 - GIGAZINE
・関連コンテンツ

in AI, ソフトウェア, Posted by darkhorse_logmk
You can read the machine translated English article SlopCodeBench is a benchmark tool for me….