
AIを低遅延実行するための推論エンジン「Liquid RIPL」が登場、検索や決済などの低遅延が重要な場面で役立つ
AI開発企業のLiquid AIが低遅延性を重視した推論エンジン「Liquid RIPL」を発表しました。
RIPL: Real-time Intelligence When Every Millisecond Counts | Blog | Liquid AI
https://www.liquid.ai/blog/low-latency
「検索ランキング生成」「商品レコメンドシステム」「決済承認」といった処理にAIを用いる場合は、いかに遅延を小さくするかが重要となります。Liquid RIPLは低遅延性を重視して開発された推論エンジンで、Liquid AI製モデルと組み合わせて高速な応答を実現します。
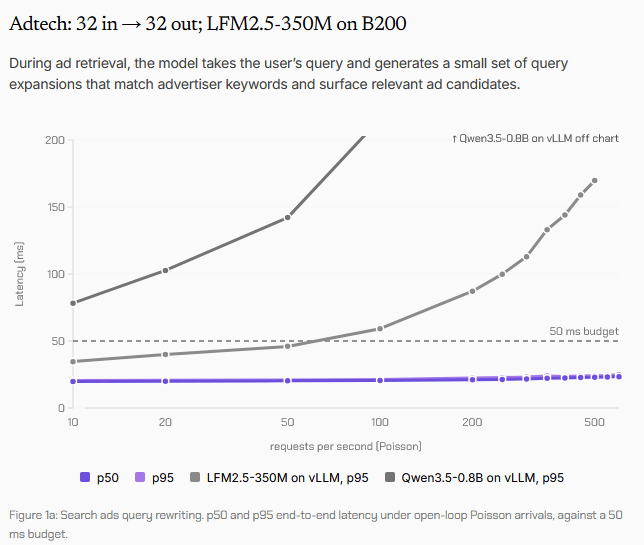
以下のグラフは「LFM2.5-350MをLiquid RIPLで実行(青および紫)」「LFM2.5-350MをvLLMで実行(灰色)」「Qwen3.5-0.8BをvLLMで実行(黒)」という条件での遅延を比較したグラフで、横軸が秒間リクエスト数、縦軸が遅延の長さを示しています。LFM2.5-350M同士で比較しても、Liquid RIPLの方が遅延を低く抑えられていることが分かります。
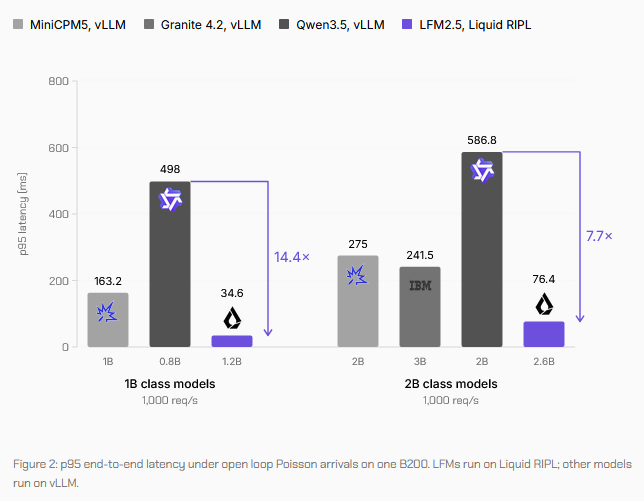
「MiniCPM5をvLLMで実行」「Granite 4.2をvLLMで実行」「Qwen3.5をvLLMで実行」「LFM2.5をLiquid RIPLで実行」という条件の遅延を比較した結果が以下。LFM2.5-1.2BをLiquid RIPLで実行した場合、Qwen3.5-0.8BをvLLMで実行するよりも遅延を14.4分の1に抑えることができます。
Liquid RIPLはH200やRTX Pro 6000といったNVIDIA製GPU上でLiquid AI製モデルを実行する用途に活用可能。料金の詳細は明らかにされておらず、利用を検討する企業がLiquid AIの営業チームに問い合わせる必要があります。
・関連記事
ハードウェアに合わせて自動最適化してオープンモデルを最大2倍高速化するAIエージェント向け推論エンジン「Magnitude」、Appleシリコン・NVIDIA・AMD・CPUに対応 - GIGAZINE
DeepSeekがAI推論システム「DeepInfer」を公開、DeepSeekの本番サービスで実際に使われているシステムのオープンソース版 - GIGAZINE
「LFM2.5-24B-A2B」が登場、Gemma 4 26B-A4BやQwen3.6 35B-A3Bより高性能でローカルエージェントとして能力を発揮 - GIGAZINE
意思決定モデル「d1-ultra」が登場、Jev 1.14を全8分野で上回り判断の信頼性も向上 - GIGAZINE
・関連コンテンツ
in AI, Posted by log1o_hf
You can read the machine translated English article Liquid RIPL, an inference engine for low….